Zaległe zgłoszenia helpdesk: jak uporządkować kolejkę?
Zaległe zgłoszenia helpdesk blokują pracę IT? Poznaj plan porządkowania kolejki, ustalania priorytetów i ograniczania zaległości w małym zespole informatyków.
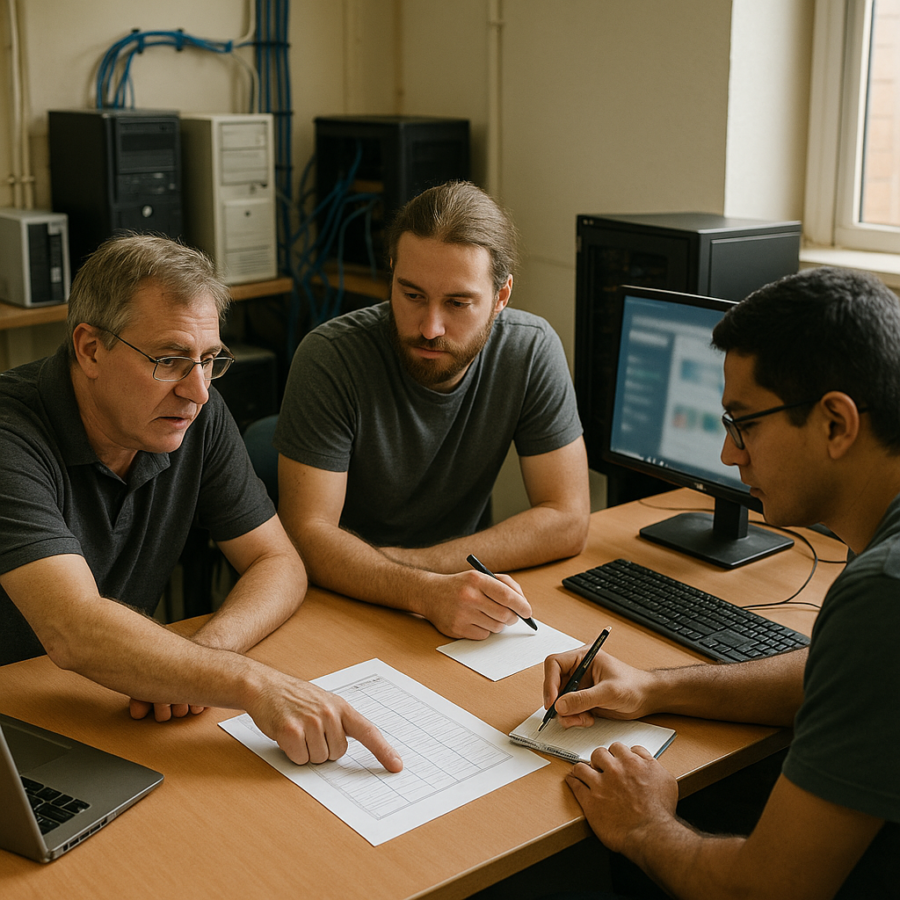
Rano otwierasz kolejkę i widzisz zgłoszenia, które miały zostać załatwione jeszcze w poprzednim tygodniu. Zanim sprawdzisz pierwsze z nich, ktoś zatrzymuje cię na korytarzu z problemem drukarki, pracownik zdalny dzwoni w sprawie VPN, a przełożony pyta o przygotowanie laptopa dla nowej osoby. Po południu okazuje się, że cały dzień był zajęty, ale najstarsze sprawy nadal stoją. W małym wewnętrznym dziale IT taki obraz nie musi oznaczać niskiej wydajności informatyków. Często wskazuje na brak zasad przyjmowania pracy, niejasne priorytety i zbyt wiele rozpoczętych zadań. Jeśli dodatkowo część spraw istnieje tylko w poczcie lub pamięci pracowników, sama liczba otwartych zgłoszeń nie pokazuje nawet pełnej skali problemu.
Redukcja zaległości IT wymaga uporządkowania dopływu pracy, ograniczenia liczby spraw realizowanych jednocześnie i podejmowania jawnych decyzji o tym, co rzeczywiście trzeba zrobić. Nie zaczyna się od masowego zamykania starych rekordów ani od polecenia zespołowi, żeby pracował szybciej. W tym poradniku znajdziesz plan dla działu liczącego od jednej do kilku osób: od przeglądu kolejki, przez ustalenie odpowiedzialności, po codzienną organizację pracy i rozmowę z zarządem o brakujących zasobach. Dowiesz się również, jak potraktować sprawy oczekujące na użytkownika, kiedy eskalować blokadę i jak mierzyć postęp bez premiowania powierzchownych rozwiązań. Plan można rozpocząć w zwykłym arkuszu i podczas krótkiego spotkania zespołu. Dopiero uporządkowany sposób pracy warto utrwalić w systemie zgłoszeniowym.
Jak ustalić rzeczywistą wielkość zaległości?
Oddziel otwarte zgłoszenia od faktycznych zaległości
Zaległe zgłoszenia helpdesk to sprawy, które przekroczyły uzgodniony termin albo pozostają bez postępu dłużej, niż dopuszczają przyjęte zasady obsługi. Nie każde otwarte zgłoszenie jest zaległością. Wymiana komputera zaplanowana na uzgodniony termin może być prawidłowo prowadzona, mimo że rekord powstał wcześniej. Z kolei awaria uniemożliwiająca pracę może stać się zaległością bardzo szybko, jeżeli nikt nie podejmie jej w wymaganym czasie. Na początku określ więc osobno termin reakcji, oczekiwany termin przywrócenia działania i termin kolejnego kontaktu. Jeżeli firma nie ma formalnego SLA, ustal robocze zasady z przełożonym. Bez takiego punktu odniesienia zespół będzie oceniał kolejkę na podstawie intuicji, a użytkownicy według własnych oczekiwań.
Pierwszy przegląd przeprowadź na jednym zestawieniu obejmującym identyfikator sprawy, datę wpływu, osobę odpowiedzialną, wpływ na pracę, obecny status, ostatnią istotną czynność i następny krok. Nie potrzebujesz od razu rozbudowanego raportowania. Arkusz wystarczy, jeśli jest dostępny dla zespołu, odpowiednio chroniony i aktualizowany w ustalony sposób. Dopisz do niego także sprawy z poczty, komunikatorów oraz notatek, ale unikaj tworzenia drugiego, stale utrzymywanego rejestru obok helpdesku. Celem jest zebranie rozproszonej pracy, a następnie wskazanie jednego miejsca prowadzenia spraw. Zgłoszenie dotyczące kadr opisz tak, aby dało się je obsłużyć bez kopiowania zbędnych danych osobowych do szeroko dostępnego zestawienia. Porządkowanie kolejki nie powinno zwiększać liczby osób mających dostęp do wrażliwych informacji.
Sprawdź, dlaczego każda stara sprawa nadal jest otwarta
Podczas przeglądu nadaj każdemu staremu zgłoszeniu przyczynę pozostawania w kolejce. Przydatne rozróżnienie obejmuje brak diagnozy, oczekiwanie na użytkownika, oczekiwanie na dostawcę, brak decyzji budżetowej, zaplanowany termin oraz brak dostępnego czasu wykonawcy. Takie oznaczenie wyjaśnia więcej niż samo „w toku”. Jeżeli kilkanaście spraw czeka na akceptację zakupu, dodatkowy dzień pracy administratora nie usunie blokady. Jeżeli wiele zgłoszeń zatrzymało się na prośbie o zrzut błędu, problemem może być sposób zbierania informacji. Natomiast długa lista rozpoczętych diagnoz bez kolejnego działania wskazuje na rozpraszanie pracy. W każdym przypadku potrzebna jest inna interwencja, dlatego samo sortowanie po dacie utworzenia nie stanowi jeszcze planu naprawczego.
Rozważ przykładową sytuację: trzech pracowników zgłosiło zrywanie połączenia z tym samym zasobem sieciowym, jedna osoba ponowiła temat telefonicznie, a kolejna wysłała wiadomość bezpośrednio do administratora. W kolejce może pojawić się kilka rekordów dotyczących jednej awarii. Połącz je relacją z jedną sprawą nadrzędną albo oznacz jako duplikaty, zachowując historię kontaktów i listę osób oczekujących na informację. Nie usuwaj śladów tylko po to, żeby zmniejszyć licznik. Jednocześnie sprawdź, czy podobny opis rzeczywiście oznacza wspólną przyczynę: problemy z dostępem mogą wynikać zarówno z awarii usługi, jak i z indywidualnych uprawnień. Zgłoszenia łącz dopiero wtedy, gdy masz wystarczające podstawy techniczne, a nie wyłącznie podobne tytuły lub nazwę tego samego programu.
Ustal stan początkowy, zanim zaczniesz poprawiać wyniki
Zapisz stan kolejki w dniu rozpoczęcia porządkowania. Potrzebujesz liczby wszystkich otwartych spraw, liczby faktycznych zaległości, wieku najstarszych zgłoszeń i podziału według przyczyn blokady. Warto również sprawdzić, ile spraw wpłynęło i ile zostało rozwiązanych w ostatnich porównywalnych okresach pracy. Nie mieszaj tygodnia świątecznego z pełnym tygodniem roboczym bez komentarza. Oddziel incydenty, standardowe prośby i zadania wymagające planowanej zmiany. Przygotowanie nowego stanowiska i diagnoza niestabilnej sieci mogą mieć ten sam status, ale zupełnie inny nakład pracy. Zestawienie powinno pokazywać te różnice, ponieważ zarząd łatwo odczyta sam licznik jako informację o wydajności, mimo że kolejka zawiera bardzo różne rodzaje obowiązków.
Przy okazji przeglądu sprawdź kompletność zgłoszeń, zwłaszcza tych, które kilkukrotnie wracały między informatykiem a użytkownikiem. Brak nazwy urządzenia, czasu wystąpienia problemu lub informacji o wpływie na pracę wydłuża obsługę, nawet gdy sama naprawa jest prosta. Warto przyjąć wspólny wzór informacji wymaganych w zgłoszeniu do IT i stosować go także podczas przyjmowania telefonu. Nie żądaj jednak pełnego formularza przed rozpoczęciem reakcji na poważną awarię. W pilnej sytuacji informatyk zapisuje minimum danych, podejmuje działanie i uzupełnia dokumentację później. Konkretna wskazówka na pierwszy dzień: wybierz najstarsze sprawy z każdej głównej kategorii i sprawdź ich rzeczywisty stan, zamiast mechanicznie czytać wszystkie rekordy w przypadkowej kolejności.
Jak ustawić priorytety i odpowiedzialność?
Oceniaj wpływ i pilność, nie głośność zgłaszającego
Priorytet zgłoszenia powinien wynikać z wpływu problemu na działalność oraz czasu, przez jaki firma może zaakceptować jego skutki. Wpływ opisuje zakres utrudnienia: liczbę osób, znaczenie procesu, dostępność obejścia i możliwe konsekwencje. Pilność wskazuje, jak szybko trzeba zadziałać, aby uniknąć większej szkody. Awaria drukarki na stanowisku wystawiającym dokumenty wysyłkowe może być ważniejsza niż usterka kilku monitorów w sali używanej sporadycznie. Z drugiej strony stanowisko kierownika nie powinno automatycznie otrzymywać najwyższego priorytetu tylko z powodu zajmowanego stanowiska. Ustal z przełożonym kilka zrozumiałych poziomów obsługi i opisz je przykładami z waszej firmy. Dzięki temu informatyk ma argument oparty na uzgodnionych zasadach, kiedy musi odmówić natychmiastowej realizacji kolejnej prośby.
Wiek zgłoszenia traktuj jako dodatkowy sygnał, a nie jedyną regułę ustalania kolejności. W obrębie podobnego priorytetu starsze sprawy powinny regularnie trafiać do realizacji, inaczej drobne usterki będą stale wypierane przez nowe tematy. Jednocześnie samo oczekiwanie nie może zamienić kosmetycznej zmiany w incydent krytyczny. Przykładowo użytkownik od dawna czeka na drugi monitor, ale dzisiaj pojawiła się awaria połączenia z systemem sprzedażowym. Najpierw przywracasz proces sprzedaży, jednak prośbie o monitor przypisujesz konkretny termin decyzji, zamiast ponownie pozostawiać ją bez odpowiedzi. Podejrzenie naruszenia bezpieczeństwa kieruj do właściwej procedury reakcji niezależnie od zwykłej kolejki. Takie zdarzenie wymaga oceny ryzyka, a nie tylko porównania liczby oczekujących użytkowników.
Każda sprawa potrzebuje właściciela i następnego kroku
Właściciel zgłoszenia to osoba odpowiedzialna za doprowadzenie sprawy do rozstrzygnięcia, a niekoniecznie wykonawca wszystkich czynności technicznych. Może czekać na decyzję kierownika, odpowiedź dostawcy albo termin dostępności pracownika, ale nadal pilnuje komunikacji i dalszego działania. W małym zespole przypisanie sprawy do ogólnej grupy „IT” często oznacza, że nikt nie czuje się odpowiedzialny za przypomnienie. Dlatego każda zaległość powinna mieć wskazaną osobę, opis najbliższej czynności oraz datę jej wykonania lub sprawdzenia. „Diagnoza problemu” jest zbyt ogólne. „Sprawdzić dzienniki po kolejnym rozłączeniu i skontaktować się z użytkownikiem w uzgodnionym oknie” pozwala ocenić, czy praca rzeczywiście posunęła się naprzód i czego potrzeba do jej kontynuowania.
Status oczekiwania nie może służyć do chowania problemu poza widokiem zespołu. Jeśli sprawa czeka na zakup przełącznika, zanotuj osobę podejmującą decyzję, przedstawione warianty i termin ponowienia pytania. Jeżeli blokadą jest dostępność pracownika hybrydowego, uzgodnij konkretne okno kontaktu, zamiast codziennie wykonywać przypadkowy telefon. Wstrzymywanie zegara SLA zależy od przyjętych uzgodnień; nie należy zakładać, że każdy status „oczekuje” automatycznie zatrzymuje termin. Nawet przy prawidłowej pauzie warto nadal obserwować całkowity wiek sprawy. Praktyczna zasada brzmi: podczas codziennego przeglądu każde zgłoszenie bez następnego kroku wraca do właściciela do uzupełnienia. To prosty sposób wykrywania tematów, które formalnie są obsługiwane, lecz w rzeczywistości przestały się poruszać.
Kontroluj rozpoczętą pracę i ustal reguły zamykania
Limit pracy w toku określa maksymalną liczbę spraw, nad którymi zespół lub konkretna osoba aktywnie pracuje równocześnie. Nie jest limitem przyjmowania zgłoszeń ani usprawiedliwieniem dla ignorowania awarii. Jego celem jest ograniczenie przełączania uwagi i zwiększenie liczby zadań doprowadzanych do końca. W jednoosobowym dziale można zacząć od jednej większej diagnozy oraz osobno obsługiwanych pilnych przerwań, a potem dostosować zasadę do rzeczywistego rytmu pracy. W zespole kilkuosobowym liczbę aktywnych spraw ustalcie wspólnie, uwzględniając dyżur i specjalizacje. Gdy pojawia się pilny incydent, jawnie wskażcie, którą pracę odkładacie i jaki ma to wpływ na termin. Bez tego wszystkie sprawy pozostają pozornie aktywne, chociaż dostępna uwaga zespołu już się wyczerpała.
Osobno uzgodnij warunki zamknięcia zgłoszenia. Rozwiązanie powinno opisywać wykonaną czynność, sposób sprawdzenia efektu oraz ewentualne ograniczenia, które nadal obowiązują. Jeżeli zastosowano obejście, można zakończyć obsługę incydentu zgodnie z przyjętymi zasadami, ale trwałą naprawę trzeba zapisać jako powiązane zadanie z właścicielem. Brak odpowiedzi użytkownika nie jest dowodem usunięcia awarii. W takich przypadkach zastosuj wcześniej zakomunikowaną procedurę przypomnienia i zakończenia administracyjnego, odróżniając je w raportach od potwierdzonego rozwiązania. Nie zamykaj w ten sposób nierozstrzygniętych spraw o istotnym wpływie lub ryzyku bez dodatkowej oceny. Najważniejsza wskazówka: liczba zamkniętych rekordów ma wynikać z rzeczywistego rozstrzygnięcia pracy, a nie być celem osiąganym przez zmianę statusów.
Jak przeprowadzić porządkowanie i utrzymać efekty?
Zaplanuj pierwsze dwa tygodnie bez zatrzymywania obsługi
Pierwszego dnia zbierz rozproszoną pracę i zapisz stan początkowy. W kolejnych dniach przejrzyj sprawy najstarsze oraz te o największym wpływie, przypisz właścicieli i uzgodnij dalsze kroki. Nie zakładaj, że cały zespół może wyłączyć bieżącą obsługę na czas porządków. Wyznacz osobę przyjmującą pilne tematy albo, przy jednoosobowym IT, ustal przedziały na przegląd nowych zgłoszeń i osobne bloki pracy nad zaległościami. Przykładowym punktem startowym jest codzienny chroniony blok trwający około godziny, lecz jego długość trzeba dopasować do obciążenia i dostępności zastępstwa. Przełożony powinien wiedzieć, że w tym czasie zwykłe prośby czekają na planowy przegląd, a tylko określone sytuacje przerywają pracę. Bez takiego uzgodnienia blok pozostanie wyłącznie wpisem w kalendarzu.
Pod koniec pierwszego tygodnia wybierz niewielką partię zaległości, które zespół realnie potrafi zakończyć w następnym okresie. Uwzględnij zarówno krótkie zadania, jak i przynajmniej jedną starszą sprawę wymagającą większego skupienia. Sama obsługa łatwych próśb poprawia licznik, lecz pozostawia najtrudniejsze problemy bez rozwiązania. W przykładowym trzyosobowym dziale jedna osoba może pełnić rotacyjny dyżur kontaktowy, druga pracować nad ustaloną naprawą sieci, a trzecia realizować zaplanowane przygotowanie stanowisk i wybraną partię zaległości. Nie jest to gotowy podział dla każdej firmy, tylko sposób oddzielenia przerwań od pracy wymagającej ciągłości. W drugim tygodniu sprawdź, czy dyżur nie stał się przeciążonym wąskim gardłem i czy specjalista prowadzący naprawę rzeczywiście miał warunki do jej zakończenia.
Ogranicz ponowne zgłoszenia i napraw przyczyny powtarzalnej pracy
Zarządzanie kolejką zgłoszeń obejmuje również sposób dopływu nowych spraw. Nie wystarczy ogłosić zakazu telefonowania, gdy formularz jest niejasny, a użytkownik nie otrzymuje informacji o przyjęciu problemu. Ustal podstawowy kanał, pokaż prostą instrukcję i wyjaśnij, jak zgłaszać awarie uniemożliwiające skorzystanie z tego kanału. Zgłoszenie przyjęte na korytarzu powinno zostać zapisane, a pracownik powinien dostać identyfikator sprawy i informację o następnym kontakcie. Dobrze zaplanowany portal zgłoszeniowy dla pracowników pomaga uporządkować komunikację, ale działa dopiero wtedy, gdy IT konsekwentnie aktualizuje statusy. Jeśli użytkownik przez kilka dni widzi wyłącznie „nowe”, zaczyna szukać informatyka innymi drogami. Powstają duplikaty, a czas zespołu zamiast na diagnozę trafia na wielokrotne odpowiadanie na to samo pytanie.
Po pierwszym porządkowaniu wybierz powtarzalny problem, który regularnie generuje pracę, i sprawdź możliwość usunięcia jego przyczyny. Może to być niestabilne urządzenie sieciowe, niejednolita konfiguracja laptopów albo niejasna procedura nadawania uprawnień. Nie każdą usterkę trzeba od razu rozwiązywać zakupem sprzętu; czasem wystarczy poprawienie standardu konfiguracji, zaplanowane okno konserwacyjne lub instrukcja dla użytkowników. Rozwiązania powtarzalnych spraw zapisuj w krótkiej bazie wiedzy, podając objawy, warunki zastosowania i sposób sprawdzenia efektu. Dopiero na takiej podstawie warto stosować reguły automatycznego przypisywania zgłoszeń. Automatyzacja nie powinna zgadywać odpowiedzialności z przypadkowych słów w tytule. Musi mieć bezpieczną ścieżkę dla spraw nierozpoznanych, a zespół powinien regularnie sprawdzać błędne przypisania i korygować reguły.
Mierz przepływ pracy i pokazuj zarządowi decyzje do podjęcia
Kolejka maleje wtedy, gdy w danym okresie więcej spraw rzeczywiście kończy obsługę, niż do niej trafia. Dlatego obok liczby zaległości obserwuj wpływ nowych zgłoszeń, liczbę rozwiązań, wiek nadal otwartych spraw i ponowne otwarcia. Połączenia duplikatów oraz zamknięcia administracyjne pokazuj osobno, żeby nie przedstawiać porządkowania ewidencji jako wzrostu zdolności naprawczych. Analizuj też czas od wpływu do zakończenia, ale nie opieraj oceny tylko na średniej: kilka bardzo starych spraw oraz duża liczba szybkich odpowiedzi mogą zniekształcić obraz. Przy porównywaniu okresów zachowaj podobny podział kategorii i odnotuj urlopy, większe wdrożenia lub awarie. W przeciwnym razie zwykła zmiana rodzaju pracy zostanie błędnie uznana za spadek wydajności zespołu.
Na cotygodniowym przeglądzie pokaż przełożonemu nie tylko liczby, lecz także blokady wymagające decyzji. Komunikat „mamy dużo zgłoszeń” niewiele zmienia. Informacja, że grupa spraw zależy od wymiany wadliwego urządzenia, a kolejna od zatwierdzenia zakresu uprawnień, pozwala wskazać konkretnych decydentów. Uporządkowany arkusz i krótka odprawa mogą wystarczyć na początek. Gdy ręczne łączenie historii, terminów i dokumentacji zaczyna zajmować zbyt dużo czasu, ANANAS24 dla wewnętrznych działów IT może pomóc prowadzić obsługę zgłoszeń i dokumentację w jednym środowisku. System nie zastąpi jednak decyzji o priorytetach ani czasu na realizację. Jeśli napływ pracy stale przekracza możliwości zespołu, zarząd musi wybrać między ograniczeniem zakresu, zmianą terminów, usunięciem źródeł awarii i zwiększeniem dostępnych zasobów.
FAQ: najczęstsze pytania o zaległości w helpdesku
Od czego zacząć, gdy zaległych zgłoszeń jest bardzo dużo?
Zacznij od widoczności i ryzyka, nie od próby przeczytania całej historii każdego rekordu. Zbierz sprawy w jednym miejscu, sprawdź najstarsze zgłoszenia oraz te dotyczące zatrzymanych procesów, bezpieczeństwa i niedotrzymanych uzgodnień. Następnie podziel kolejkę według przyczyny oczekiwania i wskaż właścicieli. Pierwsza partia pracy powinna obejmować zarówno pilne naprawy, jak i porządkowanie oczywistych duplikatów, ale obie czynności raportuj oddzielnie. Nie obiecuj dat zakończenia wszystkich spraw, zanim nie poznasz blokad i dostępności zespołu. Podaj za to termin kolejnej informacji. Przykładowo użytkownik może otrzymać potwierdzenie, że do ustalonego dnia IT zweryfikuje problem i zaproponuje sposób działania. Taki komunikat jest uczciwszy i bardziej użyteczny niż deklaracja szybkiej naprawy bez wykonanej diagnozy.
Czy można automatycznie zamknąć stare zgłoszenia bez odpowiedzi użytkownika?
Można przyjąć procedurę administracyjnego kończenia określonych spraw po nieskutecznych próbach kontaktu, ale sam wiek zgłoszenia nie wystarcza do takiej decyzji. Zasada powinna określać, kiedy wysyłane jest przypomnienie, jak długo trwa oczekiwanie i w jaki sposób użytkownik może wrócić do tematu. Trzeba również odróżnić brak odpowiedzi po zaproponowanym rozwiązaniu od sytuacji, w której IT w ogóle nie przeprowadziło diagnozy. Nie stosuj zbiorczego zamykania do nierozstrzygniętych awarii o istotnym wpływie ani spraw związanych z bezpieczeństwem bez oceny osoby odpowiedzialnej. W historii zapisz przyczynę zakończenia i ostatnią próbę kontaktu. W raportach traktuj takie zamknięcie inaczej niż potwierdzoną naprawę. Dzięki temu malejąca liczba rekordów nie będzie ukrywać problemów, które nadal występują w firmie.
Ile czasu mały dział IT powinien przeznaczać na redukcję zaległości?
Nie ma jednej właściwej wartości, ponieważ obciążenie zależy od awaryjności środowiska, liczby pracowników, zakresu odpowiedzialności i bieżących wdrożeń. Zacznij od stałego bloku pracy, który faktycznie można ochronić przed zwykłymi przerwaniami, a po kilku dniach oceń rezultat. Jeśli każdego dnia cały blok znika przez pilne sprawy, trzeba sprawdzić, czy priorytety są nadawane prawidłowo oraz czy zespół ma jakąkolwiek rezerwę operacyjną. W jednoosobowym IT rozwiązaniem może być uzgodnione okno oddzwaniania i wykonywania standardowych próśb, przy zachowaniu osobnej ścieżki dla poważnych awarii. Nie buduj planu na założeniu stałych nadgodzin. To zwiększa ryzyko błędów i nie usuwa nierównowagi między napływem a zdolnością realizacji. Czas na zaległości musi być widoczną częścią planu pracy zaakceptowanego przez przełożonego.
Jak rozpoznać, czy problemem jest organizacja pracy, czy zbyt mały zespół?
Najpierw sprawdź, ile czasu pochłania szukanie informacji, ponowne diagnozowanie tych samych usterek, obsługa duplikatów i przełączanie między rozpoczętymi zadaniami. Jeśli po uporządkowaniu tych obszarów liczba spraw rozwiązywanych rośnie, organizacja pracy helpdesku była istotnym źródłem opóźnień. Nie oznacza to jednak automatycznie, że zasoby są wystarczające. Jeżeli przez kolejne porównywalne okresy napływ uzasadnionej pracy nadal przekracza możliwości obsługi, a starsze zgłoszenia pozostają bez realizacji, potrzebna jest decyzja o zakresie lub zasobach. Uwzględnij także zadania niewidoczne w zwykłej kolejce: utrzymanie kopii zapasowych, aktualizacje, dokumentację i przygotowanie zmian. Zespół może wyglądać na mało wydajny w liczbie zamkniętych próśb, choć znaczną część czasu przeznacza na obowiązki konieczne dla ciągłości działania firmy.
Kiedy poinformować zarząd, że zaległości nie da się usunąć obecnymi zasobami?
Poinformuj zarząd od razu, gdy zagrożony jest istotny proces, bezpieczeństwo lub uzgodniony termin, którego niedotrzymanie ma znaczące konsekwencje. Nie czekaj wtedy na zakończenie pełnego pomiaru. W przypadku trwałego przeciążenia przedstaw dane z kilku porównywalnych okresów oraz działania organizacyjne, które już podjęto. Pokaż, które sprawy odkładacie, jaki jest skutek tego odroczenia i jakie warianty decyzji są dostępne. Mogą to być zmiana zakresu obsługi, ograniczenie jednoczesnych wdrożeń, zakup usuwający powtarzalną awarię albo czasowe wsparcie przy określonym zadaniu. Nie sprowadzaj rozmowy wyłącznie do prośby o dodatkowy etat. Dobrze przygotowana eskalacja pokazuje zależność między kosztem, terminem i ryzykiem oraz wskazuje osobę, która ma wybrać akceptowalny dla firmy wariant.
Źródła
- The Kanban Guides — oficjalne przewodniki metody Kanban. Materiały wyjaśniają zarządzanie przepływem pracy, ograniczanie pracy w toku i wykorzystanie pomiarów. Stanowią podstawę podejścia do kolejki, ale nie narzucają firmie konkretnych terminów obsługi.
- Microsoft Learn — oficjalna dokumentacja techniczna. Dokumentacja pomaga weryfikować procedury diagnozy i naprawy środowiska Microsoft. Instrukcję należy dobrać do używanego produktu i rzeczywistej konfiguracji, zamiast kopiować rozwiązanie z podobnie brzmiącego zgłoszenia.
- CERT Polska — materiały dotyczące bezpieczeństwa i reagowania. Publikacje pomagają rozpoznawać sytuacje, które wymagają reakcji na zagrożenie, a nie zwykłego oczekiwania w kolejce. Szczegółowy sposób działania trzeba połączyć z firmową procedurą i oceną konkretnego zdarzenia.
Jak wykorzystać źródła przy porządkowaniu kolejki?
Przewodnik dotyczący przepływu pracy jest punktem odniesienia do projektowania zasad, a nie gotową instrukcją organizacji konkretnego działu IT. Limit aktywnych zadań, rytm przeglądów i sposób rozpoznawania blokad trzeba dopasować do warunków firmy. Inaczej pracuje jedna osoba odpowiadająca również za zakupy i wdrożenia, a inaczej kilkuosobowy zespół z rotacyjnym dyżurem. Proponowany w artykule plan pierwszych dwóch tygodni jest przykładem wdrożenia, nie wynikiem badania ani gwarantowanym terminem usunięcia zaległości. Podobnie przykłady przydziału zadań służą pokazaniu mechanizmu. Ich skuteczność należy ocenić na podstawie wieku spraw, liczby rzeczywistych rozwiązań i wpływu zmian na bieżącą obsługę użytkowników, a nie wyłącznie zgodności z przyjętym harmonogramem spotkań.
Dokumentację techniczną wykorzystuj przede wszystkim przy weryfikowaniu rozwiązań i tworzeniu powtarzalnych instrukcji. Dobra notatka ze zgłoszenia powinna wskazywać nie tylko zastosowane działanie, lecz także warunki, w których było ono właściwe. To chroni przed mechanicznym powtarzaniem naprawy, która w innym środowisku może okazać się nieskuteczna albo ryzykowna. Materiały dotyczące bezpieczeństwa pomagają natomiast rozpoznać sytuacje wymagające odrębnej ścieżki reakcji. Podejrzenie przejęcia konta nie powinno czekać razem z prośbami o wyposażenie stanowiska. Jeżeli zdarzenie może wiązać się z obowiązkami prawnymi, sposób postępowania i ewentualnego zgłaszania należy potwierdzić według aktualnych przepisów oraz firmowych ustaleń. Sam status zgłoszenia w helpdesku nie rozstrzyga charakteru incydentu ani wymaganych działań.
Podsumowanie: mniejsza kolejka to wynik świadomych decyzji
Skuteczne porządkowanie helpdesku zaczyna się od odpowiedzi na trzy pytania: co naprawdę czeka, dlaczego czeka i kto wykona następny krok. Dopiero potem można sensownie ustalać kolejność realizacji. Zbierz rozproszoną pracę, odróżnij otwarte sprawy od zaległości i zachowaj historię podczas łączenia duplikatów. Każdej sprawie przypisz właściciela oraz termin działania lub ponownego sprawdzenia. Priorytet opieraj na wpływie i pilności, a najstarsze zgłoszenia regularnie przeglądaj, żeby nie zostały trwale zepchnięte przez nowe prośby. Nie próbuj poprawiać wyniku masowym zamykaniem rekordów. Użytkownik oczekuje działającego stanowiska, dostępu do zasobu lub jasnej decyzji, a nie korzystnej zmiany w raporcie. Wiarygodność zespołu rośnie wtedy, gdy status odpowiada rzeczywistości, a zapowiedziany kontakt następuje w uzgodnionym terminie.
Utrzymanie efektów wymaga ochrony czasu na realizację i ograniczenia liczby równocześnie rozpoczętych spraw. Wprowadź krótki przegląd operacyjny, ustal ścieżkę dla pilnych awarii i konsekwentnie zapisuj zgłoszenia przyjmowane poza podstawowym kanałem. Obserwuj nie tylko końcowy licznik, lecz także napływ pracy, wiek otwartych tematów, blokady oraz powroty problemów uznanych wcześniej za rozwiązane. Powtarzalne usterki traktuj jako kandydatów do trwałej naprawy, standaryzacji lub przygotowania instrukcji. Jeżeli mimo tych zmian kolejka nadal rośnie, pokaż przełożonemu konkretne warianty decyzji i ich konsekwencje. Mały dział IT nie usunie trwałego niedoboru zasobów lepszym sortowaniem listy. Może natomiast udokumentować skalę problemu, ograniczyć zbędną pracę i sprawić, że dostępny czas trafia do spraw najważniejszych dla działania firmy.
Pasjonat IT - wie wszystko o sprawach związanych z obsługą informatyczną. Prywatnie lubi chodzić po górach i czytać książki (o IT oczywiście).