Eskalacja zgłoszeń IT: procedura i kontrola SLA
Sprawdź, kiedy eskalować zgłoszenia IT, jak przekazać diagnozę i kto pilnuje SLA. Praktyczna procedura dla małego działu IT, z przykładami i listą zasad.
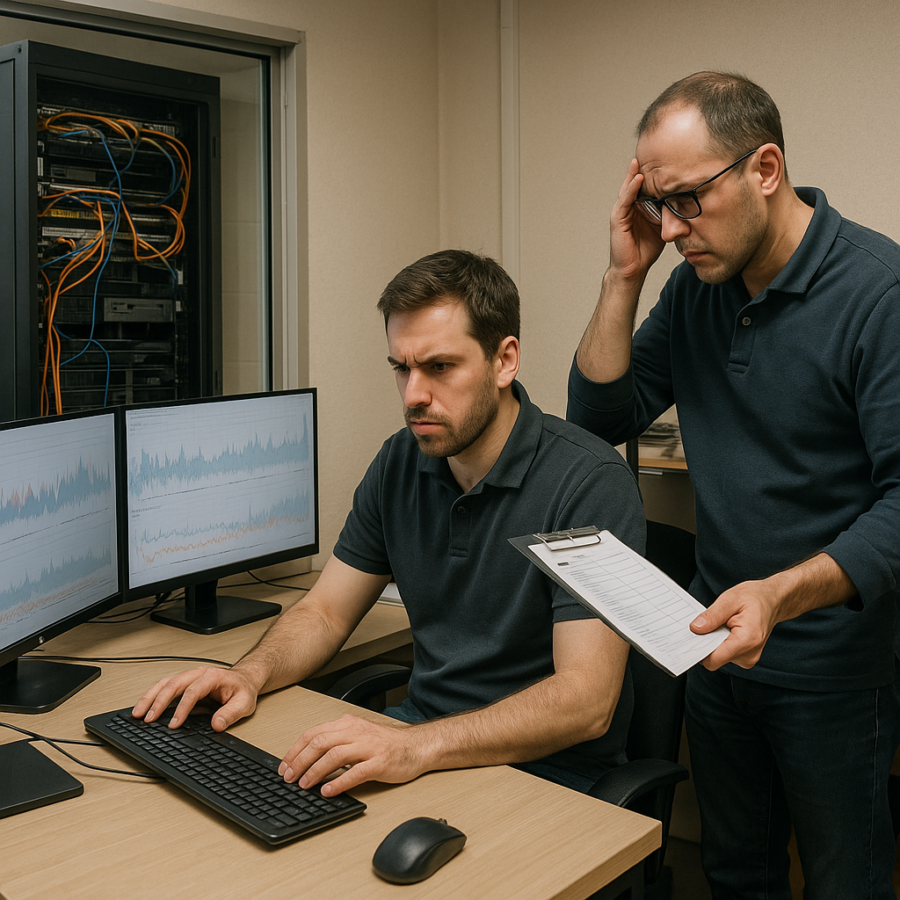
Użytkownicy nie mogą pracować w systemie magazynowym, telefon dzwoni co kilka minut, a informatyk od godziny sprawdza ten sam serwer. Restart usługi nie pomógł, kopia zapasowa jest dostępna, ale nie wiadomo jeszcze, czy problem dotyczy aplikacji, bazy danych, czy pamięci masowej. Osoba znająca środowisko najlepiej jest poza biurem, a dostawca aplikacji oczekuje opisu diagnostyki. W takiej sytuacji największym ryzykiem nie jest samo przekazanie sprawy komuś innemu. Jest nim przekazanie jej bez ustalenia, kto dalej pilnuje terminu, kto rozmawia z użytkownikami i kiedy nastąpi następna decyzja. Zgłoszenie może formalnie zmienić wykonawcę, a mimo to przez kolejną godzinę nikt nie wykona żadnego działania.
Eskalacja zgłoszeń IT powinna uruchamiać dodatkowe kompetencje, uprawnienia albo decyzje, nie usuwać odpowiedzialności z kolejki działu IT. W zespole liczącym od jednej do pięciu osób nie ma sensu budować wielopiętrowej struktury wsparcia. Potrzebne są za to czytelne zasady: po czym rozpoznać konieczność eskalacji, komu przekazać sprawę, co dołączyć do zgłoszenia i jak liczyć czas podczas oczekiwania na pomoc. Ten poradnik pokazuje rozwiązanie dla wewnętrznego działu IT obsługującego pracowników, sprzęt w różnym wieku i środowisko, którego nie da się wymienić jednym zakupem. Znajdziesz tu również sposób na rozmowę z kierownikiem biznesowym, gdy dalsze działania wymagają przerwy w pracy, zgody na koszt albo zaakceptowania ryzyka. Wszystkie opisane reguły można najpierw wdrożyć organizacyjnie, a dopiero później odwzorować w narzędziu.
Czym jest eskalacja zgłoszeń IT i kto odpowiada za sprawę?
Eskalacja funkcjonalna i eskalacja hierarchiczna
Eskalacja funkcjonalna oznacza przekazanie pracy osobie lub zespołowi mającemu kompetencje albo uprawnienia potrzebne do dalszego działania. Może to być administrator sieci, opiekun aplikacji, dostawca sprzętu lub zewnętrzny specjalista z wcześniej uzgodnionym zakresem pomocy. Eskalacja hierarchiczna oznacza natomiast skierowanie sprawy do osoby uprawnionej do podjęcia decyzji organizacyjnej lub biznesowej. Kierownik nie musi diagnozować przełącznika. Może jednak zatwierdzić awaryjny zakup, przerwę techniczną albo przesunięcie innych prac. Oba rodzaje eskalacji mogą występować równolegle. Gdy uszkodzenie urządzenia odcina halę od systemu produkcyjnego, specjalista ustala sposób przywrócenia łączności, a osoba zarządzająca produkcją decyduje, czy można bezpiecznie zatrzymać proces na czas przełączenia. Rozdzielenie tych ścieżek ogranicza sytuacje, w których technik czeka na decyzję od niewłaściwej osoby.
W praktyce samo dodanie przełożonego do korespondencji nie jest jeszcze skuteczną eskalacją. Wiadomość musi wskazywać, czego potrzebujesz, do kiedy potrzebujesz odpowiedzi i co stanie się przy jej braku. Zamiast pisać, że sytuacja jest pilna, opisz niedostępne funkcje, grupę pracowników dotkniętych awarią, dostępne obejście oraz decyzję do zatwierdzenia. Przykładowo: zapasowy switch umożliwi odtworzenie części połączeń, ale wymaga odłączenia sieci na czas przełożenia przewodów; kierownik zakładu powinien wskazać dopuszczalny moment przerwy. Taki komunikat pozwala podjąć decyzję nawet osobie bez wiedzy technicznej. W procedurze warto oddzielić pole „potrzebna pomoc techniczna” od pola „potrzebna decyzja”, ponieważ jedno zgłoszenie może wymagać obu działań i mieć dla nich różnych adresatów.
Poziomy wsparcia IT to role, a nie liczba zatrudnionych
Poziomy wsparcia IT opisują zakres wykonywanej pracy, a nie obowiązkowy schemat organizacyjny. Pierwszy poziom przyjmuje zgłoszenie, ustala wpływ i wykonuje bezpieczne czynności opisane w instrukcjach. Kolejny zajmuje się pogłębioną diagnozą i zmianami wymagającymi większych uprawnień. Następny może obejmować producenta, opiekuna kodu aplikacji lub specjalistę od konkretnej technologii. W małym dziale jedna osoba może wykonywać zadania kilku poziomów, zależnie od problemu. Nie oznacza to jednak, że powinna samodzielnie podejmować każdą decyzję. Administrator może znać sposób odtworzenia bazy, lecz nie mieć prawa zdecydować o utracie danych wprowadzonych po ostatniej kopii. W takim przypadku potrzebuje nie wyższego poziomu technicznego, lecz akceptacji właściciela procesu biznesowego.
W dwuosobowym dziale IT użyteczniejsza od rozbudowanego diagramu będzie prosta mapa kompetencji i zastępstw. Dla sieci, aplikacji, tożsamości, kopii zapasowych i bezpieczeństwa zapisz osobę prowadzącą, zastępcę oraz kontakt awaryjny. Dodaj informację, kto może zamówić płatną pomoc i gdzie są dane potrzebne do założenia zgłoszenia u producenta. Przykładowo informatyk obsługujący stanowiska może rozpocząć diagnostykę problemu VPN, ale zmiany w regułach dostępu wykonuje druga osoba. Podczas jej nieobecności nie należy improwizować ani korzystać z cudzych danych logowania. Procedura powinna wskazywać wcześniej zatwierdzony sposób zastępstwa lub uruchomienia wsparcia zewnętrznego. Sprawdź tę mapę przed urlopami, ponieważ poprawna lista kontaktów nie wystarczy, jeżeli nikt obecny nie ma uprawnień do skorzystania z opisanej ścieżki.
Właściciel zgłoszenia pozostaje widoczny po przekazaniu pracy
Właściciel zgłoszenia odpowiada za koordynację, nawet jeśli diagnozę prowadzi ktoś inny. Jego zadaniem jest pilnowanie następnego kroku, terminu aktualizacji, ryzyka przekroczenia SLA i komunikacji z pracownikami. Wykonawca odpowiada za konkretne działania techniczne. Te role można połączyć, ale nie należy zakładać, że zawsze należą do tej samej osoby. Przy awarii aplikacji jej dostawca może analizować logi, administrator sprawdzać infrastrukturę, a wyznaczony informatyk zbierać ustalenia i informować kierownika działu. Bez tego rozdzielenia użytkownik otrzymuje trzy różne odpowiedzi albo nie otrzymuje żadnej. Sam status „przekazane do dostawcy” nie wskazuje, kto ma zadzwonić ponownie, jeśli odpowiedź nie nadejdzie, ani kto ma uruchomić obejście.
Zmiana właściciela powinna następować dopiero po świadomym przyjęciu odpowiedzialności przez następcę. Nie musi to wymagać skomplikowanego obiegu: wystarczy zapis w zgłoszeniu, kto przejmuje koordynację, od kiedy i jaki jest najbliższy punkt kontrolny. Do tego momentu sprawę prowadzi dotychczasowy właściciel albo wyznaczony koordynator dyżuru. Wyobraź sobie awarię rozpoczętą przed końcem dnia pracy, gdy administrator przekazuje temat koledze obsługującemu pracowników hybrydowych. Samo przypisanie nazwiska nie daje pewności, że kolega widział zgłoszenie i ma dostęp do środowiska. Krótka rozmowa, potwierdzenie odbioru oraz zapis stanu diagnostyki zapobiegają pozostawieniu awarii bez opieki. To szczególnie ważne w małych zespołach, gdzie równolegle trwa wdrożenie, odbiór sprzętu lub wyjazd do oddziału.
Kiedy eskalować zgłoszenie: czas, wpływ i granice samodzielnej pracy
Wyznacz próg eskalacji przed upływem SLA
Zgłoszenie trzeba eskalować wtedy, gdy przewidywany czas dalszej obsługi zagraża ustalonemu terminowi, a nie dopiero po jego przekroczeniu. Próg powinien uwzględniać czas przyjęcia sprawy przez kolejną osobę, diagnozę, wykonanie zmiany i sprawdzenie rezultatu. Jeżeli specjalista zwykle nie jest dostępny od razu, pozostawienie mu ostatnich minut obowiązującego okna nie jest realnym planem. Nie istnieje jeden właściwy procent wykorzystania SLA, po którym każda sprawa powinna zmienić wykonawcę. Inaczej wygląda awaria pojedynczej drukarki z dostępnym urządzeniem zastępczym, a inaczej brak dostępu do systemu obsługującego wysyłki. Dla każdej istotnej kategorii ustal więc punkt przeglądu oraz warunki wcześniejszego przekazania. Na początku mogą to być proste reguły zapisane w instrukcji dyżuru, a nie automatyczne mechanizmy.
Załóżmy przykładowo, że wewnętrzne uzgodnienie przewiduje przywrócenie krytycznej usługi w ciągu czterech godzin objętych wsparciem. Przyjęcie sprawy przez dostawcę i późniejszy test mogą zająć istotną część tego czasu. W takim scenariuszu sensowne jest otwarcie ścieżki zewnętrznej równolegle z lokalną diagnozą, jeśli pierwsze ustalenia wskazują na aplikację. Nie trzeba czekać, aż administrator wyczerpie wszystkie pomysły dotyczące serwera. Dokładny próg powinien wynikać z uzgodnionych warunków wsparcia dostawcy oraz doświadczeń z wcześniejszych zdarzeń. Zapisz też, kto podejmuje decyzję, gdy prognoza jest niepewna. W praktyce lepsza będzie krótka konsultacja z możliwością wycofania zgłoszenia niż wielogodzinna samodzielna diagnoza podjęta wyłącznie po to, aby nie angażować drugiej osoby.
Brak kompetencji, uprawnień lub bezpiecznego następnego kroku
Eskalacja techniczna jest potrzebna również wtedy, gdy do terminu pozostało dużo czasu, ale dalsza samodzielna praca podnosi ryzyko. Dotyczy to między innymi niejasnego stanu macierzy, podejrzenia uszkodzenia danych, problemów z tożsamością uprzywilejowaną lub zmian wpływających na wiele usług. Przyjmij zasadę, że informatyk powinien potrafić wskazać cel następnej czynności, oczekiwany wynik oraz sposób wycofania zmiany. Jeżeli nie potrafi tego zrobić, potrzebuje konsultacji zamiast kolejnego eksperymentu. Podobnie należy postąpić, gdy wymagane są uprawnienia, których dana osoba nie ma. Eskalacja nie jest uzasadnieniem dla obchodzenia kontroli dostępu. Dobrze zapisana procedura chroni administratora przed presją użytkowników oczekujących natychmiastowego działania niezależnie od możliwych skutków.
Praktycznym sygnałem ostrzegawczym jest powtarzanie tych samych testów bez nowej hipotezy. Jeśli ponowne uruchomienie usługi nie przyniosło efektu, kolejny restart bez ustalenia przyczyny może jedynie usunąć przydatne ślady albo wydłużyć przerwę. W procedurze określ punkt konsultacji po wykonaniu podstawowej diagnostyki, a nie sztywną liczbę dowolnych prób. Przy podejrzeniu naruszenia bezpieczeństwa ścieżka powinna być jeszcze krótsza: uruchom plan reagowania, ogranicz zagrożenie zgodnie z posiadanymi uprawnieniami i poinformuj odpowiedzialną osobę. Decyzje dotyczące obowiązków prawnych, ochrony danych oraz zgłoszeń do instytucji wymagają odrębnej oceny według aktualnych przepisów. Technik nie powinien samodzielnie traktować takiego zdarzenia jak zwykłej awarii tylko dlatego, że użytkownik zgłosił je jako problem z otwarciem pliku.
Zmiana wpływu biznesowego wymaga ponownej oceny
Priorytet zgłoszenia nie jest ustaleniem obowiązującym bez zmian do końca obsługi. Początkowo problem może dotyczyć jednego pracownika, a po kilkunastu minutach ujawnić się w całym oddziale. Może też okazać się, że pozornie drobna awaria blokuje zadanie z nieprzesuwalnym terminem, choć technicznie dotyczy jednego stanowiska. Właściciel zgłoszenia powinien aktualizować ocenę wpływu i pilności po otrzymaniu nowych informacji. Pomaga w tym wcześniej uzgodniona macierz wpływu i pilności zgłoszeń IT, która ogranicza podejmowanie decyzji na podstawie stanowiska osoby dzwoniącej. Zmiana priorytetu powinna mieć zapisane uzasadnienie oraz skutki dla terminów, kolejki i wymaganej komunikacji. Nie należy podnosić priorytetu wyłącznie po to, aby uzyskać zainteresowanie dostawcy.
Przykładowo pracownik zgłasza na korytarzu, że nie może drukować etykiet. Dopiero krótkie pytania pokazują, że zatrzymane są wszystkie stanowiska pakowania, a urządzenie zastępcze nie obsługuje wymaganego formatu. Informatyk powinien najpierw zarejestrować rzeczywisty zakres zdarzenia i przekazać informację osobie odpowiedzialnej za pracę magazynu. Następnie uruchamia wsparcie właściwe dla wspólnego elementu infrastruktury, zamiast naprawiać każde stanowisko osobno. Konkretna wskazówka organizacyjna brzmi: przy każdej eskalacji ponownie sprawdź liczbę dotkniętych osób, zablokowany proces i dostępność obejścia. Te trzy informacje mogą całkowicie zmienić sposób prowadzenia sprawy. Jeśli podczas rozmowy wyjdzie na jaw, że awaria zaczęła się wcześniej niż zgłoszenie, zapisz oba momenty i zastosuj regułę początku SLA wynikającą z uzgodnień.
Jak przekazać zgłoszenie, żeby następna osoba nie zaczynała od zera?
Pakiet eskalacyjny: objawy, zakres i wykonane działania
Pakiet eskalacyjny to zestaw informacji umożliwiających podjęcie następnego działania bez ponownego zbierania podstawowych danych. Powinien obejmować identyfikator zgłoszenia, usługę i urządzenia objęte problemem, czas wystąpienia, wpływ biznesowy, aktualny priorytet oraz obowiązujący termin. Potrzebny jest dokładny opis objawów, a nie jedynie stwierdzenie, że aplikacja nie działa. Dopisz, co użytkownik próbował zrobić, jaki otrzymał komunikat i czy problem występuje lokalnie, zdalnie czy w obu trybach pracy. Oddziel potwierdzone fakty od hipotez. Zapis „błąd pojawia się po zalogowaniu na trzech sprawdzonych kontach” daje podstawę do diagnozy; zapis „prawdopodobnie baza” bez uzasadnienia może skierować kolejną osobę na niewłaściwy trop. Dodaj także informacje o ostatnich zmianach, nawet jeśli ich związek z awarią nie jest jeszcze potwierdzony.
Druga część pakietu powinna przedstawiać wykonane czynności razem z ich wynikami. Sama lista restartów i testów nie wystarcza, ponieważ odbiorca musi wiedzieć, co zostało wykluczone, a co nadal jest możliwe. Przykładowo opisz, że dostęp do usługi sprawdzono z sieci biurowej i po VPN, problem wystąpił w obu przypadkach, a inne usługi na tym samym serwerze odpowiadały prawidłowo. Jeśli zmieniono konfigurację, wskaż zakres, czas, osobę wykonującą i informację o wycofaniu lub pozostawieniu zmiany. Podstawę takiego opisu można oprzeć na wzorze poprawnego zgłoszenia do IT, rozszerzonym o przebieg diagnostyki. Ostatnie zdanie powinno jasno wskazywać oczekiwanie wobec odbiorcy: analizę logów, sprawdzenie konkretnego komponentu, konsultację ryzyka albo wykonanie określonego działania.
Materiały diagnostyczne przekazuj bez ujawniania zbędnych danych
Logi, zrzuty ekranu i wycinki konfiguracji powinny wspierać diagnozę, ale nie mogą być przypadkowym eksportem całego środowiska. Przed przekazaniem sprawdź, czy materiały zawierają hasła, tokeny, dane osobowe, poufne dokumenty lub informacje niezwiązane z problemem. Udostępnij tylko potrzebny zakres, kanałem zatwierdzonym w organizacji i z dostępem ograniczonym do właściwych osób. Jeśli producent wymaga szerszego pakietu diagnostycznego, ustal warunki jego przekazania z osobą odpowiedzialną za bezpieczeństwo lub ochronę danych. Nie zakładaj, że dowolny załącznik można wysłać zwykłą pocztą tylko dlatego, że odbiorca świadczy wsparcie. Zasady przechowywania i usuwania takich materiałów powinny wynikać z polityki organizacji oraz aktualnych wymagań prawnych; ten poradnik nie zastępuje ich oceny.
W praktyce użyteczność materiałów zależy również od kontekstu czasowego. Log obejmujący cały tydzień bez wskazania chwili błędu może opóźnić analizę bardziej niż krótki, właściwie opisany wycinek. Podaj przedział zdarzenia, strefę czasową oraz informację o ewentualnych rozbieżnościach zegarów, jeśli je wykryto. Zrzut ekranu opatrz opisem czynności, która doprowadziła do komunikatu. Nie nadpisuj oryginalnych materiałów, gdy mogą być potrzebne do analizy incydentu bezpieczeństwa; przygotuj osobną kopię do udostępnienia według obowiązującej procedury. Przykładowo awaria widoczna tylko u pracowników zdalnych wymaga informacji o sposobie połączenia i momencie testu, a nie przesłania pełnej zawartości ich komputerów. Dobrą praktyką jest przygotowanie szablonu opisu załącznika, który wymusza wskazanie celu jego przekazania.
Odbiór zgłoszenia musi być potwierdzony
Skuteczne przekazanie kończy się potwierdzeniem przyjęcia pracy, a nie wysłaniem wiadomości. W przypadku wewnętrznego specjalisty oznacza to uzgodnienie, że widział sprawę, ma możliwość działania i zna najbliższy termin. Przy dostawcy trzeba odróżnić automatyczne nadanie numeru od rozpoczęcia obsługi przez uprawnioną osobę. W zgłoszeniu wewnętrznym zapisz numer sprawy zewnętrznej, sposób kontaktu, oczekiwany termin odpowiedzi oraz ścieżkę ponownego kontaktu, jeśli odpowiedź nie nadejdzie. Jeżeli odbiorca odmawia przyjęcia, wymaga dodatkowych danych lub wskazuje inny zakres umowy, sprawa nadal wymaga aktywnej koordynacji. Nie może trafić do bezterminowego oczekiwania. Właściciel powinien ustalić alternatywny krok, na przykład konsultację z przełożonym, uruchomienie innego kanału wsparcia lub wdrożenie wcześniej zatwierdzonego obejścia.
W pilnej awarii warto zastosować przekazanie podczas krótkiej rozmowy, a jej ustalenia od razu zapisać. Osoba prowadząca przedstawia objawy, sprawdzone hipotezy i ostatnią zmianę, natomiast odbiorca potwierdza następne działanie oraz termin informacji zwrotnej. Nie chodzi o długie spotkanie wszystkich zainteresowanych, lecz o usunięcie niejasności przed rozpoczęciem pracy. Taki sposób jest szczególnie przydatny przed końcem zmiany lub wyjazdem administratora do oddziału. Unikaj natomiast równoległego zlecania kilku osobom niezależnych zmian w tym samym komponencie. Jeśli dwie ścieżki diagnostyczne są potrzebne, właściciel zgłoszenia powinien rozdzielić zakresy i określić, kto zatwierdza działania mogące wpływać na pozostałe testy. W przeciwnym razie nie będzie wiadomo, która zmiana pomogła, a która wprowadziła nowy problem.
Eskalacja a SLA: jak pilnować czasu, komunikacji i wyniku?
Przekazanie sprawy nie zeruje ani nie zatrzymuje zegara
Eskalacja a SLA to dwa powiązane mechanizmy: pierwszy zmienia sposób prowadzenia sprawy, drugi określa uzgodnione warunki i terminy obsługi. Przeniesienie zgłoszenia do innej kolejki nie powinno samoistnie uruchamiać czasu od początku. Oczekiwanie na producenta także nie stanowi automatycznej podstawy do zatrzymania pomiaru. Ewentualne wyłączenia muszą wynikać z wcześniej przyjętych zasad i być widoczne w historii sprawy. Wewnętrzny dział IT powinien rozdzielić czas reakcji, czas przywrócenia działania i czas trwałego usunięcia przyczyny, jeśli takie miary są stosowane. Różnice między nimi wyjaśnia poradnik o czasie reakcji i rozwiązania zgłoszenia w SLA. Automatyczne potwierdzenie odbioru nie musi oznaczać spełnienia uzgodnionej reakcji, jeżeli organizacja wymaga podjęcia realnych czynności przez człowieka.
Na wynik pomiaru wpływa również kalendarz wsparcia. Jeżeli pomoc jest dostępna w określonych godzinach, trzeba ustalić sposób liczenia czasu poza tym przedziałem, podczas dni wolnych oraz przy zgłoszeniach od pracowników hybrydowych. Przykładowo awaria zgłoszona pod koniec dnia nie daje podstaw do obiecywania całodobowej pracy, jeśli firma nie zapewnia dyżuru. Z drugiej strony krytyczna usługa może wymagać odrębnej ścieżki awaryjnej, zaakceptowanej przez kierownictwo. Zapisuj czas wystąpienia zdarzenia, przyjęcia zgłoszenia, rozpoczęcia diagnozy i eskalacji jako osobne fakty. Gdy zmienia się priorytet, zachowaj wcześniejsze wartości oraz przyczynę zmiany. Reguła przeliczenia terminu powinna być ustalona wcześniej, a nie wybierana dopiero wtedy, gdy jeden wariant daje korzystniejszy wynik raportu.
Ustal rytm aktualizacji i plan na brak odpowiedzi
Każda eskalowana sprawa powinna mieć najbliższy punkt kontrolny, nawet gdy nikt nie potrafi jeszcze podać terminu naprawy. Punkt kontrolny jest zobowiązaniem do sprawdzenia sytuacji i podjęcia decyzji, a nie obietnicą rozwiązania problemu. Użytkownik potrzebuje wiedzieć, czy zgłoszenie pozostaje aktywne, czy może skorzystać z obejścia i kiedy otrzyma kolejną informację. Przy zdarzeniu dotykającym całego działu wyznacz jedną osobę kontaktową po stronie biznesowej, aby administrator nie musiał odpowiadać osobno na każdą rozmowę telefoniczną. Aktualizacja powinna zawierać stan faktyczny, wykonane działania, najbliższy krok oraz ryzyko dla uzgodnionego terminu. Nie przekazuj prognozy dostawcy jako pewnego zobowiązania, jeśli nadal zależy ona od wyników analizy. Odróżnienie prognozy od potwierdzonego terminu pomaga zachować wiarygodność.
Brak odpowiedzi w punkcie kontrolnym powinien uruchamiać konkretną ścieżkę, a nie kolejne bezterminowe oczekiwanie. Najpierw zweryfikuj odbiór, następnie użyj uzgodnionego kanału eskalacyjnego dostawcy lub zastępstwa wewnętrznego, a równolegle oceń dostępne obejście. Jeśli zagrożony jest termin biznesowy, poinformuj osobę decyzyjną przed jego upływem. Dla przykładu dostawca aplikacji nadal analizuje błąd, ale zbliża się moment zamknięcia wysyłek. Kierownik magazynu może zdecydować o uruchomieniu zatwierdzonej procedury awaryjnej, o ile zna ograniczenia i ryzyka. Informatyk powinien przedstawić warianty wraz z ich konsekwencjami, nie przerzucać na kierownika wyboru nieopisanych działań technicznych. W zgłoszeniu zapisz decyzję i osobę, która ją zaakceptowała, aby później nie odtwarzać ustaleń z pamięci uczestników rozmowy.
Zacznij od prostej procedury, później automatyzuj
Procedura eskalacji helpdesk może początkowo mieścić się w krótkim dokumencie i wspólnym rejestrze. Potrzebujesz przypisanego właściciela, aktualnego wykonawcy, terminu SLA, progu eskalacji, następnego punktu kontrolnego i kontaktu zastępczego. Dodaj wzór pakietu diagnostycznego oraz zasady przekazania odpowiedzialności. Następnie przeprowadź próbę na hipotetycznej awarii sieci, problemie z aplikacją i zgłoszeniu odebranym tuż przed urlopem jedynego administratora. Sprawdź, czy wskazane osoby wiedzą, że mają określoną rolę, oraz czy potrafią uzyskać potrzebny dostęp. Taki test często ujawnia więcej niż samo zatwierdzenie dokumentu. Szczególnie wartościowe jest przećwiczenie sytuacji, w której pierwszy kontakt nie odpowiada, ponieważ właśnie wtedy procedura musi wskazać realną alternatywę, a nie tylko listę nazwisk.
Dopiero po sprawdzeniu zasad warto odwzorować je w narzędziu: przypomnieniach kalendarza, wspólnym rejestrze albo systemie zgłoszeniowym. Przy ocenie ANANAS24 dla wewnętrznego działu IT sprawdź na własnym scenariuszu, jak obsłużyć właściciela sprawy, historię ustaleń i nadzór nad terminami; zakres automatyzacji potwierdź przed wdrożeniem. Najważniejsze jest to, aby system wspierał uzgodniony proces, zamiast zastępować go domyślnym statusem oczekiwania. Po przywróceniu usługi zbadaj czas od decyzji o eskalacji do przyjęcia pracy, liczbę przekazań oraz przyczyny opóźnień. Zamknięcie zgłoszenia powinno wynikać z potwierdzonego spełnienia kryteriów przywrócenia działania. Jeśli zastosowano tylko obejście, pozostaw osobne, powiązane zadanie dotyczące trwałego rozwiązania, z właścicielem i terminem przeglądu.
FAQ: najczęstsze pytania o eskalację zgłoszeń IT
Po jakim czasie należy eskalować zgłoszenie IT?
Zgłoszenie należy eskalować przed momentem, w którym zabraknie czasu na przyjęcie sprawy przez kolejną osobę, wykonanie pracy i sprawdzenie rezultatu. Nie ma jednego uniwersalnego limitu właściwego dla każdej kategorii awarii. Próg ustala się na podstawie wpływu biznesowego, pozostałego czasu SLA, dostępności specjalisty i zakresu wykonanej diagnostyki. Wcześniejsza eskalacja jest potrzebna przy braku wymaganych uprawnień, ryzyku utraty danych lub podejrzeniu naruszenia bezpieczeństwa. Dla powtarzalnych zdarzeń warto określić punkt konsultacji po wykonaniu opisanych testów. Jeżeli administrator nie ma bezpiecznego następnego kroku, powinien poprosić o pomoc niezależnie od czasu pozostałego do terminu. Przy nowym rodzaju awarii lepiej przeprowadzić krótką konsultację i wspólnie ustalić plan niż kontynuować diagnozę bez hipotezy tylko po to, aby formalnie wykorzystać przyznane okno.
Czy oczekiwanie na dostawcę pozwala wstrzymać SLA?
Oczekiwanie na dostawcę nie wstrzymuje SLA automatycznie. Możliwość wyłączenia określonego okresu z pomiaru musi wynikać z obowiązujących uzgodnień, a przyczyna i czas takiej decyzji powinny być zapisane w historii. Sam status zgłoszenia nie tworzy podstawy do zatrzymania zegara. Wewnętrzny dział IT musi również sprawdzić, czy zobowiązania dostawcy pozwalają dotrzymać terminów przyjętych wobec pracowników. Jeżeli producent działa w węższych godzinach albo gwarantuje jedynie reakcję, nie należy na tej podstawie obiecywać szybkiego przywrócenia usługi. Nawet dopuszczalne zatrzymanie pomiaru nie usuwa skutków biznesowych awarii. Dlatego warto równolegle pokazywać rzeczywisty czas niedostępności, utrzymywać komunikację i sprawdzać możliwość uruchomienia obejścia. Wyłączenie z rozliczenia SLA nie oznacza zwolnienia z koordynacji sprawy.
Kto jest właścicielem zgłoszenia po eskalacji?
Właścicielem pozostaje osoba odpowiedzialna za koordynację, dopóki ktoś inny świadomie nie przyjmie tej roli. Przekazanie diagnozy dostawcy lub administratorowi specjalizującemu się w danej technologii nie musi oznaczać zmiany właściciela. Koordynator nadal pilnuje komunikacji, kolejnego punktu kontrolnego, ryzyka przekroczenia SLA i ewentualnej potrzeby decyzji biznesowej. W małym dziale IT ta sama osoba może jednocześnie wykonywać część diagnostyki, ale powinna wiedzieć, kiedy potrzebuje zastępstwa. Przy zmianie dyżuru trzeba potwierdzić odbiór sprawy oraz przekazać stan prac, terminy i kontakty. Samo ustawienie innego nazwiska w zgłoszeniu nie daje pewności, że sprawa jest obsługiwana. Warto także zapisać, kto przejmuje rolę podczas nagłej nieobecności, aby awaria nie pozostawała bez koordynacji do powrotu konkretnego pracownika.
Jak zorganizować eskalację, gdy w firmie pracuje jeden informatyk?
Jednoosobowy dział IT potrzebuje eskalacji tak samo jak większy zespół, ale jego ścieżki prowadzą głównie do dostawców, zewnętrznych specjalistów oraz osób podejmujących decyzje biznesowe. Należy wcześniej ustalić, kto może zatwierdzić dodatkowy koszt, przerwę w pracy lub uruchomienie procedury awaryjnej. Trzeba również zapewnić zatwierdzony sposób zastępstwa, dostęp do dokumentacji oraz możliwość zgłoszenia awarii podczas nieobecności informatyka. Nie oznacza to udostępniania haseł całemu kierownictwu. Chodzi o kontrolowany mechanizm uruchomienia pomocy z odpowiednimi uprawnieniami. Praktycznym początkiem jest tabela usług z kontaktem technicznym, właścicielem biznesowym i warunkami wsparcia. Następnie należy przećwiczyć scenariusz urlopu oraz awarii poza godzinami pracy. Jeżeli firma oczekuje ciągłej dostępności, musi świadomie zapewnić zasoby i zastępstwo zamiast opierać cały model na prywatnym telefonie jednej osoby.
Czy wdrożenie obejścia pozwala zamknąć zgłoszenie?
Wdrożenie obejścia pozwala zakończyć etap przywracania działania tylko wtedy, gdy spełnia wcześniej uzgodnione kryteria dostępności i zostało właściwie zweryfikowane. Nie każde częściowe uruchomienie funkcji oznacza przywrócenie usługi. Jeżeli pracownicy mogą wykonywać zadania, ale tracą istotne możliwości lub działają z dodatkowym ryzykiem, ograniczenia trzeba opisać i uzgodnić z właścicielem procesu. Pomiar SLA powinien odpowiadać jego definicji: termin przywrócenia działania może być czymś innym niż termin trwałego usunięcia przyczyny. Po zakończeniu incydentu pozostaw powiązane zadanie dotyczące naprawy docelowej, jeżeli nadal jest potrzebna. Przypisz odpowiedzialną osobę oraz termin przeglądu. Bez tego obejście łatwo staje się nieudokumentowanym stanem stałym, a kolejna awaria rozpoczyna identyczną diagnozę i ponowne szukanie osoby, która pamięta wcześniejsze ustalenia.
Podsumowanie: eskaluj odpowiednio wcześnie, ale nie oddawaj sprawy bez nadzoru
Skuteczna eskalacja zgłoszeń IT nie polega na jak najszybszym przekazaniu trudnego problemu dalej. Jej celem jest zapewnienie kompetencji, uprawnień lub decyzji potrzebnych do przywrócenia działania, z zachowaniem odpowiedzialności za cały przebieg obsługi. W małym dziale IT najwięcej daje kilka prostych ustaleń: widoczny właściciel sprawy, czytelny próg konsultacji, pakiet diagnostyczny i obowiązek potwierdzenia odbioru. Każda eskalowana awaria powinna mieć następny krok oraz moment ponownej oceny. Dzięki temu oczekiwanie na specjalistę nie staje się okresem, w którym nikt nie kontaktuje się z użytkownikami i nie sprawdza pozostałego czasu. Równie ważne jest rozdzielenie diagnozy technicznej od decyzji biznesowej, zwłaszcza gdy dalsze działania wymagają przerwy, dodatkowego kosztu albo zaakceptowania ograniczeń.
Zacznij od przeglądu kilku ostatnich trudnych zgłoszeń. Ustal, gdzie rzeczywiście tracono czas: przed decyzją o eskalacji, przy zbieraniu brakujących informacji, podczas oczekiwania na odbiór czy przy uzyskiwaniu zgody kierownika. Na tej podstawie przygotuj krótką procedurę i przetestuj ją z osobami, które mają uczestniczyć w obsłudze. Dopiero później ustawiaj automatyczne przypomnienia i reguły. SLA nie powinno być poprawiane przez zmianę statusu, zerowanie licznika ani zamykanie sprawy po wysłaniu jej do producenta. Powinno pokazywać realizację uzgodnionych warunków, a historia zgłoszenia powinna wyjaśniać przebieg zdarzenia. Najlepszym rezultatem nie jest brak eskalacji, lecz sytuacja, w której pomoc uruchamia się odpowiednio wcześnie, pracownicy wiedzą, co się dzieje, a dział IT potrafi wskazać odpowiedzialnego za każdy kolejny krok.
Źródła
Dokumentacja narzędzi pomaga wdrożyć reguły, ale ich nie zastępuje
Dokumentacja producenta jest właściwym miejscem do sprawdzania mechanizmów powiadamiania, uprawnień oraz sposobu kontaktowania się ze wsparciem. Nie rozstrzyga jednak, jaką dostępność usługi firma rzeczywiście potrzebuje i kto może zaakceptować przerwę w pracy. Te zasady muszą wynikać z wewnętrznych ustaleń, umów oraz oceny ryzyka. Materiały Microsoft Learn pomagają odnaleźć informacje właściwe dla używanej usługi i jej kanałów wsparcia, natomiast dokumentacja Zabbix opisuje między innymi działania oraz eskalowanie powiadomień. Eskalacja alertu w monitoringu nie jest tożsama z przekazaniem odpowiedzialności za zgłoszenie. Powiadomienie może dotrzeć do kolejnej osoby, choć nikt nie potwierdził jeszcze rozpoczęcia diagnozy. Wdrażając automat, trzeba zatem połączyć mechanizm techniczny z organizacyjnym potwierdzeniem odbioru i zasadą dalszej koordynacji.
Przykładowo monitoring wykrywa niedostępność usługi i wysyła kolejne powiadomienie, ponieważ stan nie wrócił do normy. Samo powtórzenie alertu nie odpowiada na pytanie, czy administrator jest dostępny, czy zna wpływ biznesowy i czy potrzebuje decyzji kierownika. Przed uruchomieniem takiej reguły sprawdź w dokumentacji warunki wykonania, sposób zakończenia sekwencji oraz zachowanie przy zmianie stanu zdarzenia. Następnie przetestuj ją na kontrolowanym przykładzie, który nie zakłóca pracy użytkowników. W procedurze zapisz oczekiwany rezultat, a szczegółową konfigurację przechowuj w dokumentacji technicznej. Taki podział ułatwia utrzymanie zasad po zmianie narzędzia lub sposobu powiadamiania. Nie kopiuj ustawień z przypadkowego poradnika bez sprawdzenia ich znaczenia w używanym środowisku i aktualnej dokumentacji producenta.
Źródła oficjalne i weryfikacja ścieżek reagowania
Materiały CERT Polska są pomocne przy przygotowywaniu organizacji na zdarzenia związane z cyberbezpieczeństwem. Zwykły obieg zgłoszeń nie powinien opóźniać działań ochronnych, gdy pojawia się podejrzenie przejęcia konta, złośliwego oprogramowania lub wycieku informacji. W takich sytuacjach potrzebna jest odrębna ścieżka kontaktu z osobami odpowiedzialnymi za bezpieczeństwo i decyzje organizacyjne. Ewentualne obowiązki zawiadamiania instytucji, ochrony danych i zachowania materiałów trzeba potwierdzić według aktualnych przepisów oraz sytuacji konkretnej firmy. Nie należy wyprowadzać ich wyłącznie z kategorii zgłoszenia w helpdesku. Praktyczna wskazówka polega na wskazaniu w procedurze osoby odpowiedzialnej za taką ocenę oraz jej zastępcy. Dzięki temu administrator wie, kogo zaangażować, zamiast samodzielnie interpretować wymagania prawne podczas aktywnego incydentu.
Poniższe źródła służą do weryfikacji sposobów realizacji opisanych działań, a nie jako dowód istnienia jednego uniwersalnego progu eskalacji. Przed wdrożeniem procedury sprawdź aktualność kontaktów, zakres posiadanej pomocy producenta i warunki obowiązujące dla konkretnych usług. Warto zapisać w dokumentacji wewnętrznej, kto odpowiada za okresowy przegląd tych informacji i co uruchamia dodatkową aktualizację, na przykład zmiana dostawcy, przebudowa sieci lub odejście administratora. Dobrym testem jest próba odnalezienia właściwej ścieżki przez osobę zastępującą właściciela usługi, bez korzystania z jego prywatnych notatek. Jeżeli zastępca nie potrafi ustalić sposobu zgłoszenia, wymaganych danych i osoby zatwierdzającej koszt, dokumentacja nie jest jeszcze gotowa do użycia podczas awarii. Same poprawne odnośniki nie rozwiązują tego problemu.
- Microsoft Learn — oficjalna dokumentacja usług Microsoft. Wyszukaj informacje dotyczące używanej usługi, jej diagnostyki i dostępnych kanałów pomocy. Warunki przyjmowania zgłoszeń sprawdź również w posiadanym planie wsparcia.
- Zabbix Documentation — dokumentacja monitoringu i powiadomień. Sprawdź opis działań, eskalacji powiadomień oraz warunków ich wykonywania. Konfigurację zawsze zweryfikuj dla wdrożenia używanego w organizacji.
- CERT Polska — materiały o zagrożeniach i reagowaniu na incydenty. Korzystaj z oficjalnych informacji przy przygotowywaniu ścieżki bezpieczeństwa. Wymagania dotyczące konkretnego zdarzenia potwierdź z właściwymi osobami i aktualnymi przepisami.
Pasjonat IT - wie wszystko o sprawach związanych z obsługą informatyczną. Prywatnie lubi chodzić po górach i czytać książki (o IT oczywiście).