SLA w obsłudze IT: czas reakcji i rozwiązania zgłoszenia
Jak ustalić SLA w obsłudze IT? Poznaj zasady mierzenia czasu reakcji i rozwiązania, priorytety, pauzy oraz zapisy umowne, które chronią relacje z klientami.
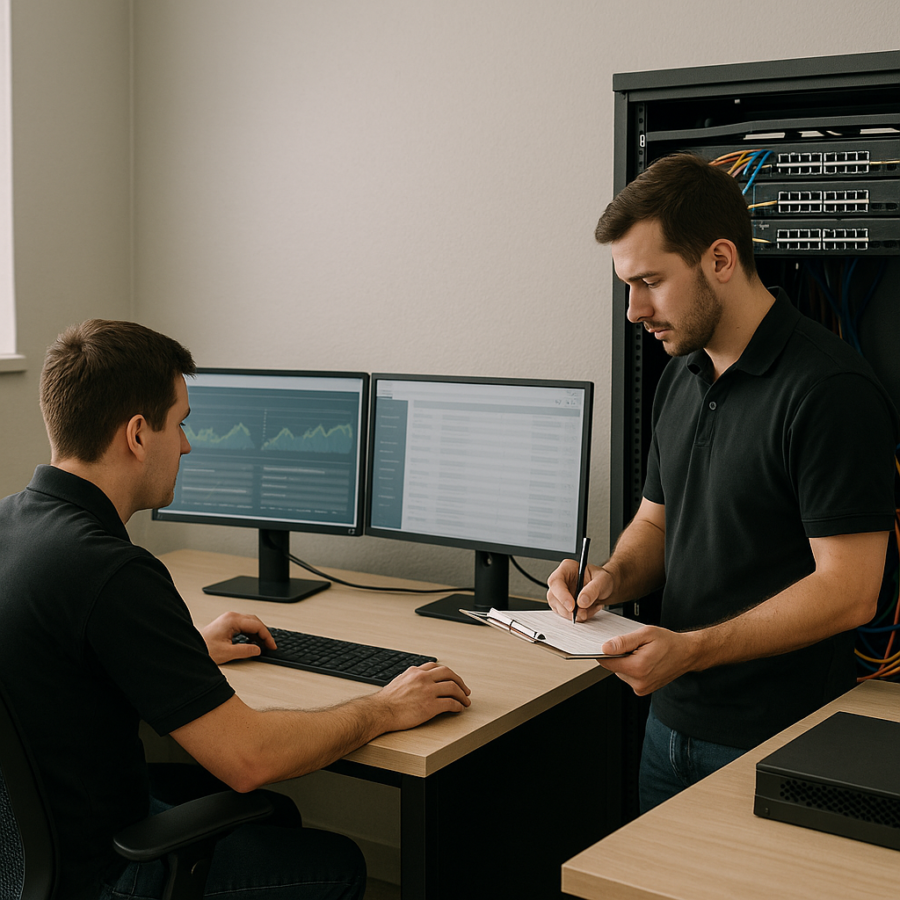
Klient zgłasza o poranku, że nie działa program magazynowy. Technik oddzwania po kilkunastu minutach, ustala zakres awarii i rozpoczyna diagnostykę. Po godzinie wiadomo już, że problem dotyczy bazy danych, ale producent aplikacji odpowiada dopiero po południu. Dla firmy świadczącej obsługę informatyczną reakcja była szybka i prawidłowa. Dla klienta usługa nadal nie działała przez znaczną część dnia. Jeżeli umowa mówi jedynie o „obsłudze zgłoszeń w ciągu czterech godzin”, obie strony mogą rozumieć ten zapis inaczej. Spór nie wynika wtedy z samej awarii, lecz z braku rozróżnienia między rozpoczęciem obsługi, przywróceniem możliwości pracy i trwałym usunięciem przyczyny problemu. Najczęściej wraca przy rozliczeniu miesiąca albo przedłużeniu umowy.
SLA w obsłudze IT powinno opisywać mierzalne zobowiązania, a nie ogólną obietnicę szybkiej pomocy. Dla właściciela lub koordynatora niewielkiej firmy serwisowej oznacza to konieczność pogodzenia oczekiwań kilku klientów z dostępnością techników, dojazdami, dyżurami i zależnościami od zewnętrznych dostawców. Jedna osoba nie może jednocześnie naprawiać sieci w siedzibie klienta i prowadzić pilnej diagnostyki u innego. W tym poradniku rozdzielimy najważniejsze zegary SLA, pokażemy sposób ustalania priorytetów oraz wyjaśnimy, kiedy można zatrzymać pomiar czasu. Znajdziesz również przykłady zapisów operacyjnych, zasady raportowania i pytania, które warto omówić z klientem przed podpisaniem umowy. Celem jest ustalenie warunków możliwych do wykonania i uczciwych do rozliczenia, także wtedy, gdy awaria nie przebiega zgodnie z planem.
Co oznaczają czas reakcji i czas rozwiązania zgłoszenia?
SLA, czas reakcji i rzeczywiste rozpoczęcie obsługi
SLA, czyli Service Level Agreement, to uzgodnienie poziomu świadczenia usługi. W obsłudze informatycznej określa między innymi zakres odpowiedzialności dostawcy, godziny wsparcia, sposób klasyfikacji zgłoszeń i terminy wykonania określonych działań. Samo zestawienie priorytetów z liczbą godzin nie wystarcza. Potrzebne są jeszcze zasady uruchamiania i zatrzymywania pomiaru, wskazanie obsługiwanych kanałów kontaktu oraz opis wyjątków. Trzeba też rozdzielić zobowiązanie umowne od wewnętrznego celu zespołu. Firma serwisowa może planować podjęcie zgłoszenia wcześniej, niż wymaga umowa, aby zachować bufor na spiętrzenie pracy. Wewnętrzny cel nie powinien jednak nieformalnie zastępować warunków, które klient otrzymał w podpisanym dokumencie.
Czas reakcji na zgłoszenie to okres od zdefiniowanego momentu jego przyjęcia do kwalifikowanej reakcji dostawcy. W praktyce warto uznać za nią potwierdzenie przez technika zakresu problemu, przypisanie odpowiedzialności oraz rozpoczęcie obsługi lub przekazanie konkretnego planu dalszych działań. Automatyczny e-mail z numerem sprawy potwierdza dostarczenie zgłoszenia, ale sam nie dowodzi rozpoczęcia pracy. Jeżeli umowa dopuszcza automatyczne potwierdzenie jako osobny parametr, trzeba nazwać go czasem potwierdzenia przyjęcia i mierzyć oddzielnie. Dzięki temu klient nie otrzymuje raportu o świetnej reakcji tylko dlatego, że serwer pocztowy odpowiedział natychmiast, podczas gdy człowiek zajrzał do zgłoszenia dopiero następnego dnia roboczego.
Wyobraźmy sobie zgłoszenie dotyczące niedziałającego połączenia VPN pracownika klienta. Technik odpowiada, że przyjął sprawę, prosi o komunikat błędu i ustala termin połączenia zdalnego. Taka czynność może zakończyć pomiar reakcji, jeżeli odpowiada uzgodnionej definicji i rzeczywiście uruchamia obsługę. Samo przesunięcie sprawy do statusu „w realizacji”, bez analizy ani kontaktu, nie powinno wystarczać. Praktyczna wskazówka: w umowie i instrukcji dla zespołu opisz zdarzenie kończące czas reakcji tak samo. Technik musi wiedzieć, co wykonać, a koordynator powinien mieć możliwość sprawdzenia tego na podstawie historii działań. Nie opieraj rozliczenia wyłącznie na aktualnym statusie, bo może on zmieniać się wielokrotnie podczas obsługi.
Przywrócenie usługi, trwałe rozwiązanie i zamknięcie sprawy
Czas przywrócenia usługi określa, jak długo trwa doprowadzenie jej do uzgodnionego poziomu użyteczności. Czas trwałego rozwiązania problemu obejmuje natomiast usunięcie przyczyny w zakresie określonym umową. Te momenty nie zawsze są identyczne. Po awarii switcha można uruchomić urządzenie zastępcze i przywrócić pracę magazynu, choć docelowy sprzęt przyjedzie później. Podobnie przeniesienie użytkownika na komputer zapasowy może zakończyć przestój, ale nie naprawia jego dotychczasowego stanowiska. W umowie można przyjąć, że skuteczne obejście kończy obsługę incydentu, jednak musi to być jasno nazwane. Nie należy przedstawiać tymczasowego przywrócenia działania jako trwałego usunięcia przyczyny, jeśli wymaga ona dalszych prac.
Czas rozwiązania zgłoszenia musi mieć jednoznaczną definicję właściwą dla danej usługi. Jeżeli oznacza odzyskanie możliwości pracy, opisz wymagany rezultat oraz dopuszczalność obejścia. Jeżeli oznacza pełne usunięcie usterki, uwzględnij wpływ dostępności części, producenta i zgody na zmianę. Zamknięcie zgłoszenia jest jeszcze innym zdarzeniem: administracyjnym zakończeniem sprawy po potwierdzeniu wyniku lub upływie ustalonego terminu na uwagi. Klient nie powinien czekać z odzyskaniem usługi na formalne zamknięcie, a dostawca nie powinien skracać raportowanego czasu przez przedwczesne zamykanie spraw. Przy odbiorze rozwiązania warto zapisać wynik testu biznesowego, na przykład potwierdzenie możliwości wystawienia dokumentu magazynowego, zamiast ogólnego stwierdzenia „serwer odpowiada”.
Dobrym punktem wyjścia są trzy osobne zdarzenia: pierwsza kwalifikowana reakcja, przywrócenie uzgodnionego działania oraz zakończenie wymaganych prac naprawczych. Nie każda usługa potrzebuje trzech twardych terminów umownych, lecz warto zachować te informacje w historii sprawy. Przy standardowej awarii stanowiska wystarczy czas reakcji i jasno zdefiniowany czas rozwiązania. Przy przestoju kluczowego systemu rozdzielenie etapów pomaga pokazać klientowi, kiedy wróciła praca i co pozostaje do zrobienia. Ustal też częstotliwość aktualizacji statusu podczas poważnego incydentu. Jest to oddzielne zobowiązanie komunikacyjne, które nie zatrzymuje zegara rozwiązania, ale ogranicza sytuacje, w których kilka osób z firmy klienta telefonuje po te same informacje.
Jak dobrać priorytety i realistyczne cele SLA?
Wpływ biznesowy i pilność zamiast kolejności telefonów
Priorytet zgłoszenia powinien wynikać z wpływu awarii na działalność klienta oraz pilności przywrócenia pracy. Wpływ opisuje skalę skutków: zatrzymany proces, liczbę dotkniętych osób i dostępność obejścia. Pilność mówi, jak szybko skutki staną się poważne. Brak drukowania u jednej osoby może być drobną niedogodnością albo blokadą wysyłek, jeżeli jest to jedyne stanowisko przygotowujące wymagane dokumenty. Z kolei awaria funkcji używanej przez wiele osób nie zawsze wymaga natychmiastowego działania, gdy proces może bezpiecznie poczekać. Przed przypisaniem terminów warto uzgodnić z klientem macierz wpływu i pilności zgłoszeń, obejmującą konkretne procesy jego firmy.
Możesz zastosować cztery poziomy priorytetu, o ile zespół i klient potrafią je odróżnić. Najwyższy poziom powinien obejmować zatrzymanie krytycznej usługi bez akceptowalnego obejścia. Kolejny może dotyczyć istotnego ograniczenia pracy działu, a następny problemów pojedynczych użytkowników, którzy nadal mogą realizować najważniejsze zadania. Najniższy poziom nadaje się do drobnych usterek i części standardowych wniosków. To jednak przykład organizacji kolejki, a nie gotowa klasyfikacja dla każdej umowy. Zamówienie nowego stanowiska lepiej rozliczać według terminu realizacji usługi i warunków jej zamówienia niż według zegara awarii. Mieszanie incydentów, zakupów i planowanych zmian utrudnia późniejsze porównywanie wyników oraz planowanie pracy techników.
W praktyce osoba zarządzająca firmą klienta może zgłosić drobną usterkę jako krytyczną, ponieważ dotyczy jej własnego komputera. Technik powinien ocenić skutek biznesowy, a nie stanowisko zgłaszającego. Jednocześnie nie wolno automatycznie obniżać priorytetu problemu jednej osoby: brak dostępu do systemu płatności tuż przed terminem może mieć duże znaczenie. Ustal, kto zatwierdza zmianę priorytetu oraz jak dokumentuje uzasadnienie. Historia musi zachować pierwotną klasyfikację, moment zmiany i zastosowaną zasadę przeliczenia terminu. Obniżenie priorytetu tuż przed przekroczeniem SLA nie może służyć poprawianiu raportu. W przypadku sporu potrzebna jest szybka ścieżka decyzji pomiędzy koordynatorem dostawcy a wskazanym przedstawicielem klienta.
Jak wyznaczyć terminy, które mały zespół może dotrzymać?
Terminy SLA ustalaj na podstawie rzeczywistej zdolności świadczenia usługi, a nie samego oczekiwania klienta. Sprawdź dotychczasowy czas podjęcia spraw, długość dojazdów, dostępność kompetencji i momenty największego obciążenia. Oddziel aktywną pracę technika od oczekiwania na użytkownika, części lub dostawcę. Oceń też scenariusz dwóch jednoczesnych awarii u różnych klientów. Jeżeli trzyosobowy zespół ma jednego specjalistę od konkretnej infrastruktury, jego urlop jest ograniczeniem usługi, które trzeba obsłużyć zastępstwem, wsparciem partnera lub zmianą zakresu zobowiązania. Sam wpis w kalendarzu nie tworzy dodatkowej dostępności. Zbyt krótki termin sprzedany wielu klientom naraz może być niewykonalny nawet wtedy, gdy każda umowa osobno wygląda rozsądnie.
Przykładowe, a nie uniwersalne parametry SLA helpdesk mogą przewidywać reakcję na awarię krytyczną w ciągu trzydziestu minut, na poważne ograniczenie usługi w ciągu dwóch godzin roboczych, a na standardową usterkę w ciągu czterech godzin roboczych. Dla prostego wniosku można przyjąć odpowiedź do następnego dnia wsparcia. Takie wartości należy zweryfikować dla konkretnej obsady i godzin działania. Nie wynikają one z powszechnego obowiązku ani jednej normy branżowej. Czas rozwiązania zgłoszenia wymaga osobnej analizy. Przywrócenie działania w kilka godzin można rozważać tam, gdzie istnieje sprawdzony sposób odtworzenia, sprzęt zastępczy i dostęp administracyjny. Bez tych warunków liczba wpisana do umowy będzie jedynie nieuzasadnioną obietnicą.
Dobrym przykładem jest klient korzystający z urządzeń w różnym wieku, bez zapasowego switcha i bez aktualnego spisu połączeń. Krótki czas przywrócenia sieci zależy wtedy nie tylko od pracy technika, lecz również od rozpoznania instalacji i zdobycia odpowiedniego sprzętu. Przed przyjęciem zobowiązania przedstaw klientowi warunki: dokumentację, urządzenie zastępcze, dostęp do pomieszczeń oraz zgodę na określony zakres działań awaryjnych. Gdy klient nie akceptuje tych warunków, zaproponuj dłuższy cel albo ograniczenie zobowiązania do reakcji i prowadzenia uzgodnionych działań. Najpierw usuń ograniczenia techniczne, później skracaj SLA. Czynnikami wpływającymi na koszt będą przede wszystkim gotowość personelu, redundancja, zapas części i obsługa poza standardowymi godzinami.
Jak liczyć czas SLA, pauzy i zależności od dostawców?
Początek pomiaru i kalendarz świadczenia wsparcia
Zegar SLA powinien rozpoczynać się od zdarzenia, które da się niezależnie odtworzyć. Może to być wpływ wiadomości na uzgodniony adres, rejestracja formularza w portalu, przyjęcie telefonu przez dyżurnego lub kwalifikacja zdarzenia z monitoringu. Każdy kanał wymaga określenia sposobu zapisu czasu. Jeżeli klient ma prawo zgłaszać telefonicznie, technik powinien odnotować rzeczywisty moment przyjęcia rozmowy, a nie dopiero późniejsze utworzenie sprawy. Zgłoszenie przekazane na korytarzu podczas wizyty także potrzebuje jasnej zasady. Najbezpieczniej zarejestrować je od razu albo poprosić o użycie uzgodnionego kanału, wyraźnie informując, czy rozmowa została już uznana za formalne zgłoszenie. Niejasność w tym miejscu przenosi się później na całe rozliczenie.
Umowa powinna wskazywać godziny i dni świadczenia wsparcia, strefę czasową oraz sposób traktowania świąt. Dwie godziny robocze nie oznaczają dwóch godzin zegarowych. Jeżeli obsługa działa od poniedziałku do piątku w godzinach 9:00–17:00, zgłoszenie przyjęte w piątek o 16:30 z terminem reakcji dwóch godzin roboczych ma termin w poniedziałek o 10:30, o ile poniedziałek jest dniem wsparcia. Zgłoszenie nocne zacznie zużywać taki limit dopiero po otwarciu kolejnego okna obsługi. Inaczej działa usługa całodobowa, w której czas biegnie również wieczorem i w weekend. Samo działanie monitoringu przez całą dobę nie oznacza całodobowej obecności technika ani zobowiązania do nocnej naprawy.
W obsłudze pracowników hybrydowych klient może oczekiwać pomocy wieczorem, bo wtedy kończy ważne zadanie. Jeżeli umowa obejmuje wyłącznie godziny biurowe, takie oczekiwanie wymaga osobnego trybu, a nie doraźnego nacisku na technika. Ustal, które zdarzenia uruchamiają dyżur, kto może go wezwać i jaki kanał kontaktu obowiązuje. Dla monitoringu określ także, czy pomiar zaczyna się od pierwszego sygnału, potwierdzenia niedostępności czy utworzenia zgłoszenia. Opóźnienie wykrycia nie znika tylko dlatego, że licznik helpdesku rusza później. Dlatego dostępność usługi i termin obsługi zgłoszenia warto mierzyć oddzielnie. Sprawdź te reguły na przykładzie awarii wykrytej w nocy, zanim zapiszesz je w umowie.
Kiedy wolno zatrzymać zegar i co zrobić z oczekiwaniem?
Pauza SLA jest dopuszczalna tylko dla wcześniej uzgodnionych okoliczności i musi mieć uzasadnienie w historii zgłoszenia. Typowy przypadek to brak informacji, dostępu lub decyzji, bez których nie można wykonać kolejnego kroku. Sam status „oczekiwanie na klienta” nie dowodzi jednak, że cała obsługa została zablokowana. Jeżeli technik może równolegle przeanalizować logi albo przygotować obejście, trzeba ustalić, czy wstrzymanie jest zasadne. Prośba o dane powinna wskazywać, co jest potrzebne, dlaczego i w jaki sposób to przekazać. Warto także wyznaczyć termin przypomnienia. Brak odpowiedzi użytkownika nie może prowadzić do wielodniowego pozostawienia krytycznej awarii bez kontaktu z osobą odpowiedzialną po stronie klienta.
Oczekiwanie na dostawcę internetu, producenta aplikacji lub część zamienną nie zatrzymuje zegara automatycznie. To zależy od konstrukcji usługi i podziału odpowiedzialności. Jeśli sprzedajesz klientowi utrzymanie określonej usługi, zewnętrzna zależność może pozostawać częścią twojego zobowiązania, chyba że umowa wyraźnie stanowi inaczej. Nawet przy dopuszczonej pauzie firma serwisowa nadal powinna eskalować sprawę, informować klienta i oceniać dostępność obejścia. W raporcie pokaż czas całkowity oraz czas rozliczany wobec SLA. Dzięki temu sytuacja, w której użytkownicy nie pracowali przez dwa dni, nie zostanie przedstawiona jako krótka awaria tylko dlatego, że większość okresu formalnie wyłączono z pomiaru. Zgodność z umową nie jest tym samym co brak wpływu biznesowego.
Przykładem poprawnego zapisu operacyjnego jest wstrzymanie zegara rozwiązania do czasu udostępnienia laptopa, jeżeli diagnostyka wymaga obecności użytkownika i nie ma innej uzgodnionej drogi dostępu. W historii należy zapisać moment prośby, przyczynę blokady i moment uzyskania dostępu. Po wznowieniu licznik kontynuuje pomiar według przyjętej reguły, a nie zaczyna automatycznie od zera. Podobnej precyzji wymaga ponowne otwarcie sprawy. Ustal, czy nieskuteczna naprawa powoduje kontynuację pierwotnego pomiaru, czy uruchamia inne rozliczenie. Jeżeli problem powrócił, ponieważ rozwiązanie nie działało od początku, utworzenie nowego zgłoszenia nie powinno zacierać wcześniejszego przekroczenia. Zasady zmiany priorytetu, pauz i wznowień przetestuj razem, ponieważ ich kombinacje najłatwiej prowadzą do błędów.
Jak wdrożyć SLA w małej firmie IT i rozliczać wyniki?
Od uzgodnień umownych do codziennej pracy techników
Wdrożenie zacznij od krótkiej karty warunków dla każdego klienta. Powinna zawierać obsługiwane usługi, godziny wsparcia, kanały zgłoszeń, priorytety, definicje reakcji i rozwiązania, zasady pauz oraz kontakty eskalacyjne. Dopisz warunki techniczne: wymagany dostęp administracyjny, odpowiedzialność za kopie zapasowe, procedurę zatwierdzania zmian i dostępność sprzętu zastępczego. Taki dokument można przygotować w edytorze tekstu i omówić na spotkaniu bez kupowania dodatkowych narzędzi. Ważniejsze od formatu jest uzgodnienie konkretnych scenariuszy. Zapytaj klienta, co ma się wydarzyć przy awarii internetu, uszkodzeniu serwera i niedostępności jednej aplikacji. Różnice w odpowiedziach pokażą niejasności znacznie szybciej niż czytanie samej tabeli czasów.
Następnie rozpisz odpowiedzialność wewnątrz firmy serwisowej. Każda nowa sprawa musi mieć właściciela, a każda nieobecność technika powinna uruchamiać przewidywalne zastępstwo. Przy niewielkiej liczbie zgłoszeń wystarczy wspólna kolejka i codzienny przegląd, ale wraz ze wzrostem liczby klientów rośnie ryzyko pozostawienia sprawy bez opiekuna. Pomagają wtedy reguły przypisywania zgłoszeń według klienta, kategorii i dyżuru. Sama automatyzacja nie rozwiązuje jednak problemu braku kompetencji lub przeciążenia. Koordynator potrzebuje informacji, czy wyznaczona osoba może podjąć sprawę, kto ją zastąpi i kiedy trzeba przekazać zadanie dalej. Nazwisko w polu wykonawcy nie jest jeszcze potwierdzeniem faktycznej obsługi.
Przed uruchomieniem rozliczeń przeprowadź próbę na historycznych zgłoszeniach i kilku przygotowanych scenariuszach. Sprawdź piątkowe popołudnie, dzień wolny, pauzę wymagającą decyzji klienta, zmianę priorytetu oraz powrót tej samej usterki. W prostym arkuszu można zestawić czas wpływu, pierwszą reakcję, okresy wstrzymania i przywrócenie działania. Gdy takie zasady są już uzgodnione, system helpdesk ułatwia utrzymanie wspólnej historii oraz nadzór nad terminami. Przykładowo ANANAS24 łączy obsługę zgłoszeń z SLA i dokumentacją, co pomaga ograniczyć rozproszenie informacji. Przed wdrożeniem zawsze sprawdź jednak, czy sposób odwzorowania kalendarzy, pauz i wyjątków odpowiada twoim umowom. Nie dopasowuj znaczenia zobowiązania do domyślnego statusu dostępnego w narzędziu.
Eskalacje, raportowanie i poprawianie usługi
Eskalacja powinna następować przed przekroczeniem SLA, a nie dopiero po reklamacji klienta. Moment ostrzeżenia dobierz tak, aby pozostał czas na realne działanie: zmianę technika, zaangażowanie specjalisty, dojazd lub uzgodnienie obejścia. Przy krótkim terminie reakcji potrzebujesz szybkiego powiadomienia o niepodjętej sprawie. Przy dłuższym czasie rozwiązania ważniejszy jest przegląd postępu i przeszkód. Eskalacja techniczna oznacza zaangażowanie dodatkowych kompetencji, a organizacyjna uruchomienie decyzji dotyczącej zasobów, ryzyka lub komunikacji z klientem. W małym zespole obie może prowadzić właściciel firmy, ale ich cel pozostaje różny. Samo wysłanie kolejnego e-maila nie pomoże, jeżeli nikt nie ma uprawnienia do przełożenia mniej pilnych prac albo wezwania zastępstwa.
Raport dla klienta powinien osobno pokazywać dotrzymanie czasu reakcji i czasu rozwiązania, z podziałem na priorytety oraz usługi. Wyjaśnij, jaki zbiór zgłoszeń jest oceniany, jak traktowane są wyłączenia i co dzieje się ze sprawami nadal otwartymi. Nie opieraj wyniku wyłącznie na średnim czasie, ponieważ pojedyncza wielodniowa awaria może zniknąć wśród wielu krótkich czynności. Pokaż liczbę przekroczeń, ich przyczyny i działania naprawcze. Uwzględnij również otwarte sprawy, które już przekroczyły termin. Jeżeli rozliczasz tylko zamknięte zgłoszenia, pozostawienie trudnego incydentu w kolejce sztucznie poprawi wynik miesiąca. Przydatne jest osobne zestawienie czasu przestoju, okresów pauzy oraz czasu aktywnej pracy zespołu.
Przegląd SLA powinien kończyć się decyzjami, a nie samym przekazaniem raportu. Jeśli problemy wynikają z braku danych kontaktowych, popraw formularz i listę osób uprawnionych. Jeżeli powtarzają się opóźnienia przy określonej aplikacji, uzgodnij wsparcie producenta lub rozwój kompetencji. Gdy technicy stale przełączają się między starymi sprawami, zacznij od uporządkowania zaległej kolejki helpdesk, zamiast dopisywać kolejne alarmy. Konsekwencje niedotrzymania umowy, w tym zasady reklamacji i ewentualnych rekompensat, trzeba opisać oddzielnie i poddać przeglądowi prawnemu. To samo dotyczy ograniczeń odpowiedzialności. Techniczny raport jest podstawą rozmowy, ale nie zastępuje poprawnie przygotowanych warunków współpracy ani oceny obowiązujących przepisów.
FAQ — najczęstsze pytania o SLA w obsłudze IT
Czy automatyczne potwierdzenie zgłoszenia jest reakcją w SLA?
Automatyczne potwierdzenie jest przede wszystkim dowodem, że zgłoszenie dotarło do uzgodnionego kanału. Może stanowić osobno zdefiniowany parametr umowny, ale nie powinno być przedstawiane jako rozpoczęcie diagnostyki przez technika. Dla przejrzystej obsługi warto mierzyć oddzielnie potwierdzenie przyjęcia i pierwszą kwalifikowaną reakcję. Ta druga powinna oznaczać konkretne działanie: ocenę wpływu, kontakt dotyczący problemu, rozpoczęcie diagnostyki albo przekazanie planu obsługi zgodnego z definicją w umowie. Jeżeli istniejąca umowa używa słowa „reakcja” bez wyjaśnienia, uzgodnij znaczenie przed kolejnym okresem rozliczeniowym. Nie zmieniaj interpretacji dopiero podczas reklamacji. Sam komunikat „otrzymaliśmy zgłoszenie” nie zapewnia klientowi wiedzy, kiedy i przez kogo sprawa zostanie podjęta, nawet jeśli zawiera numer i deklarowany priorytet.
Czy można zagwarantować czas rozwiązania każdej awarii?
Nie można odpowiedzialnie obiecać jednego krótkiego terminu dla wszystkich możliwych awarii bez określenia zakresu, warunków i zależności. Uszkodzenie urządzenia bez dostępnego zamiennika różni się od problemu, który można usunąć przywróceniem znanej konfiguracji. Dla usług krytycznych warto ustalać czas przywrócenia działania, opierając go na redundancji, przetestowanym odtwarzaniu lub przygotowanym obejściu. Trwałe usunięcie przyczyny może otrzymać osobny termin. Tam, gdzie rezultat zależy od producenta albo nietypowej diagnostyki, należy jasno określić zakres zobowiązania, obowiązek eskalacji i częstotliwość informowania klienta. Nie wystarczy ogólne zastrzeżenie, że dostawca będzie się starał. Klient powinien rozumieć, co jest gwarantowanym terminem, co celem operacyjnym, a co planem wymagającym aktualizacji po rozpoznaniu problemu.
Czy czas SLA biegnie w nocy, weekendy i święta?
Czas SLA biegnie zgodnie z kalendarzem przypisanym do konkretnego zobowiązania. Wsparcie w godzinach roboczych nalicza czas tylko w uzgodnionych oknach, natomiast zobowiązanie całodobowe może obejmować również noce, weekendy i święta. Reakcja i przywrócenie usługi nie muszą korzystać z identycznych kalendarzy, ale każda różnica musi być wyraźnie opisana. Podobnie monitoring całodobowy nie oznacza automatycznie całodobowej interwencji. W umowie trzeba wskazać strefę czasową, sposób traktowania dni wolnych oraz kanał uruchamiania dyżuru. Przy klientach pracujących zmianowo lub hybrydowo sprawdź rzeczywiste godziny używania kluczowych usług. Jeżeli pracownicy regularnie kończą zadania wieczorem, samo biurowe okno wsparcia może nie odpowiadać ich potrzebom, nawet gdy formalnie wszystkie zgłoszenia są obsługiwane zgodnie z terminem.
Czy oczekiwanie na klienta zawsze zatrzymuje czas rozwiązania?
Oczekiwanie na klienta zatrzymuje zegar tylko wtedy, gdy przewiduje to uzgodnienie SLA i rzeczywiście występuje przeszkoda uniemożliwiająca dalsze działania objęte pomiarem. Technik powinien wskazać brakującą informację, decyzję lub dostęp oraz zapisać moment zgłoszenia tej potrzeby. Nie należy wstrzymywać całej sprawy tylko dlatego, że wysłano pytanie, jeśli diagnostyka może być kontynuowana inną drogą. Warto ustalić przypomnienia i eskalację do osoby kontaktowej klienta, szczególnie podczas przestoju ważnej usługi. Raport powinien zachować zarówno pełny czas trwania sprawy, jak i czas liczony do SLA. Dzięki temu pauza wyjaśnia warunki rozliczenia, lecz nie ukrywa rzeczywistego okresu niedostępności. Po uzyskaniu odpowiedzi pomiar powinien zostać wznowiony zgodnie z wcześniej przyjętą regułą, bez dowolnego zerowania licznika.
Jak ustalić SLA, gdy firmę obsługuje tylko jeden technik?
Przy jednoosobowej obsłudze najważniejsze jest jawne określenie dostępności i zastępstwa. Krótki czas reakcji przez całą dobę wymaga czegoś więcej niż telefonu komórkowego właściciela: potrzebna jest osoba zdolna przejąć sprawę podczas choroby, urlopu, dojazdu lub innej awarii. Można ograniczyć godziny wsparcia, ustalić różne zobowiązania dla usług krytycznych i standardowych oraz uzgodnić wsparcie partnera w jasno określonych sytuacjach. Konieczne są także aktualna dokumentacja i kontrolowany dostęp do informacji potrzebnych zastępcy. Terminy należy przetestować dla dwóch równoczesnych problemów, a nie tylko spokojnego dnia pracy. Jeśli klient oczekuje krótszych czasów, trzeba omówić dodatkową gotowość i zabezpieczenia techniczne. Nie warto przyjmować zobowiązania, którego wykonanie zależy wyłącznie od stałej osobistej dyspozycyjności jednego człowieka.
Podsumowanie: dobre SLA zaczyna się od definicji, nie od liczby godzin
SLA w obsłudze IT ma sens wtedy, gdy obie strony tak samo rozumieją moment przyjęcia zgłoszenia, pierwszą reakcję i osiągnięcie wymaganego rezultatu. Najpierw opisz usługę i odpowiedzialność, następnie uzgodnij priorytety, kalendarz wsparcia oraz zasady pauz. Dopiero na tej podstawie wyznacz terminy. Czas reakcji na zgłoszenie powinien potwierdzać rzeczywiste rozpoczęcie obsługi, a czas rozwiązania zgłoszenia musi wskazywać, czy chodzi o przywrócenie możliwości pracy, czy trwałe usunięcie przyczyny. Oddziel te etapy tam, gdzie różnica ma znaczenie dla klienta. Nie pozwól również, aby administracyjne zamknięcie sprawy zastępowało potwierdzenie działania usługi. Najlepszym sprawdzianem definicji jest przejście przez konkretny scenariusz awarii wraz z osobą odpowiedzialną po stronie klienta.
Dla małej firmy serwisowej szczególnie ważna jest zgodność zobowiązań z dostępnością ludzi i warunkami technicznymi. Krótszy termin wymaga zastępstwa, właściwych kompetencji, dostępu i często sprzętu zapasowego, a nie tylko większej liczby powiadomień. Wdrożenie zacznij od jednej umowy i próbnego rozliczenia znanych zgłoszeń. Sprawdź przypadki graniczne, popraw instrukcje i dopiero wtedy przenieś reguły na kolejnych klientów. W raportach pokazuj zarówno wykonanie zobowiązań, jak i rzeczywisty wpływ awarii na działalność. Omawiaj przekroczenia bez ukrywania ich za zmianami statusu lub szerokimi wyłączeniami. Dobrze przygotowane SLA nie usuwa wszystkich awarii, lecz porządkuje odpowiedzialność, pozwala zaplanować zasoby i daje obu stronom uczciwą podstawę do rozmowy o jakości usługi.
Źródła
Dokumentacja do definiowania i pomiaru poziomu usługi
Przy projektowaniu SLA warto korzystać z materiałów, które rozdzielają zobowiązanie wobec odbiorcy od celu operacyjnego i sposobu pomiaru. Takie rozróżnienie przedstawia podręcznik Google SRE w rozdziale dotyczącym celów poziomu usługi. Nie jest to gotowy wzór umowy dla niewielkiej firmy serwisowej, lecz przydatna podstawa do ustalenia, jaki rezultat ma znaczenie dla klienta i jak go obserwować. W praktyce oznacza to oddzielenie czasu reakcji helpdesku od dostępności aplikacji, a także wewnętrznego celu zespołu od gwarancji kontraktowej. Podane w artykule przykłady terminów są propozycjami do oceny, a nie wartościami nakazanymi przez to źródło ani uniwersalnym standardem dla wszystkich usług IT.
Dokumentacja Zabbix pomaga zrozumieć pomiar dostępności usług, zależności między elementami infrastruktury oraz wykorzystanie zdarzeń monitoringu. To istotne, kiedy klient oczekuje rozliczania faktycznej niedostępności, a firma serwisowa dotychczas mierzyła wyłącznie czas życia zgłoszenia. Monitoring może wykazać awarię wcześniej niż użytkownik, ale samo wykrycie nie potwierdza rozpoczęcia pracy technika. Z kolei brak alarmu nie jest automatycznym dowodem, że proces biznesowy działał poprawnie. Przy wdrożeniu sprawdź w dokumentacji używanego narzędzia sposób definiowania usług, okresów pomiaru i wyłączeń. Wyniki porównaj z historią zgłoszeń oraz testami działania, zamiast traktować jeden wykres jako wystarczające potwierdzenie wykonania wszystkich obowiązków wynikających z umowy serwisowej.
Jak wykorzystać oficjalne materiały przy uzgadnianiu SLA?
Materiały CERT Polska są przydatne przy odrębnym planowaniu obsługi incydentów bezpieczeństwa. Podejrzenie przejęcia konta lub infekcji nie powinno trafiać bez namysłu do tej samej ścieżki co standardowa usterka drukarki. Potrzebne mogą być szybkie ograniczenie skutków, zabezpieczenie informacji oraz kontakt z wyznaczonymi osobami po stronie klienta. Umowny czas reakcji helpdesku nie zastępuje takiej procedury i nie przesądza o ewentualnych obowiązkach zgłoszeniowych. Ich zakres należy potwierdzić na podstawie aktualnych przepisów i sytuacji organizacji, z udziałem właściwego specjalisty. W praktyce warto przeprowadzić osobny scenariusz testowy dla incydentu bezpieczeństwa i sprawdzić, czy dyżurny zna ścieżkę eskalacji również wtedy, gdy nie ma jeszcze pełnego obrazu zdarzenia.
Oficjalne źródła najlepiej wykorzystać do weryfikacji konkretnych założeń, a nie do uzasadniania dowolnie wybranych terminów. Przed spotkaniem z klientem zapisz, co chcesz potwierdzić: definicję celu usługi, sposób pomiaru niedostępności albo zasady reagowania na incydent. Następnie przełóż ustalenia na opis odpowiedzialności i sprawdź je na przykładzie z własnej kolejki. Jeżeli dokumentacja opisuje funkcję techniczną, nie zakładaj, że rozstrzyga również interpretację umowy. Jeśli materiał dotyczy dużych środowisk, dobierz rozwiązanie do możliwości małego zespołu, zachowując sens pomiaru. Ostateczna karta SLA powinna być zrozumiała dla klienta bez konieczności studiowania dokumentacji producenta, a sposób jej realizacji powinien dać się odtworzyć na podstawie zapisanej historii obsługi.
- Google SRE — Service Level Objectives. Oficjalny materiał wyjaśnia relacje między wskaźnikami, celami poziomu usługi i uzgodnieniami SLA. Pomaga uporządkować pojęcia przed ustaleniem sposobu raportowania.
- Zabbix — oficjalna dokumentacja. Dokumentacja opisuje między innymi monitoring usług i mechanizmy pomiaru ich dostępności. Przy wdrożeniu należy korzystać z części odpowiadającej używanemu środowisku i sprawdzić zachowanie konfiguracji na przykładach.
- CERT Polska — materiały dotyczące cyberbezpieczeństwa. Publikacje zespołu pomagają uwzględnić specyfikę incydentów bezpieczeństwa w procedurach operacyjnych. Nie zastępują indywidualnej oceny obowiązków prawnych ani uzgodnienia odpowiedzialności między klientem a dostawcą.
Pasjonat IT - wie wszystko o sprawach związanych z obsługą informatyczną. Prywatnie lubi chodzić po górach i czytać książki (o IT oczywiście).